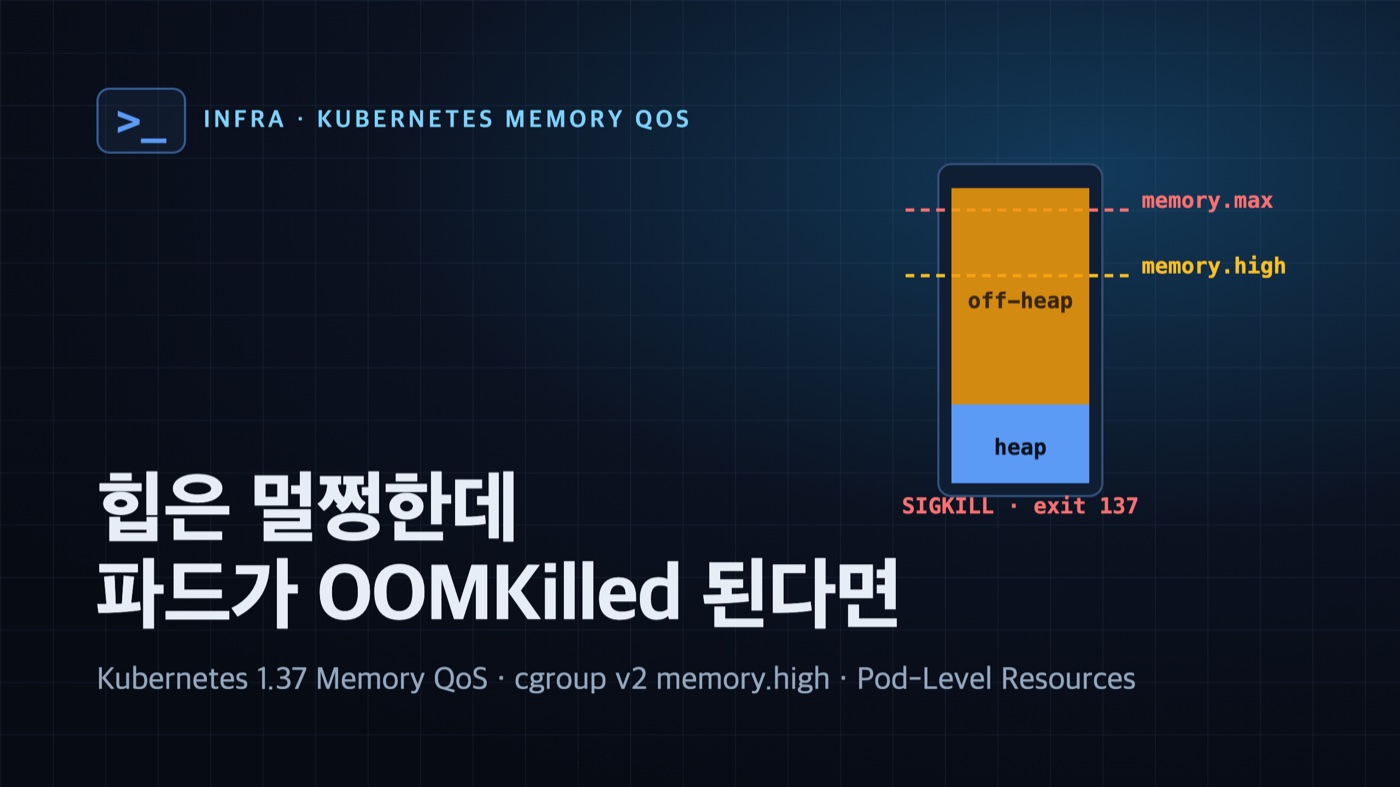
이번 포스팅에서는 Kubernetes 1.37에서 Beta로 올라온 Memory QoS와 Pod-Level Resource Managers를 백엔드 개발자 관점에서 정리하고자 한다. “힙은 절반이나 남았는데 파드가 OOMKilled로 죽었다”는 상황은 Spring Boot를 쿠버네티스에 올려 본 사람이라면 한 번쯤 겪는 일이다. -Xmx를 아무리 맞춰도 컨테이너가 통째로 죽어 버리는 이유는 컨테이너 메모리 회계가 JVM 힙과 다른 층위에서 돌아가기 때문이다. 여기서는 그 원인을 cgroup 레벨에서 짚고, Memory QoS가 OOMKill 직전에 어떻게 브레이크를 거는지, 그리고 feature gate만 켜면 왜 아무 일도 일어나지 않는지까지 실제 설정과 검증 명령어 중심으로 다룬다.
힙은 절반이나 남았는데 왜 파드는 죽었나
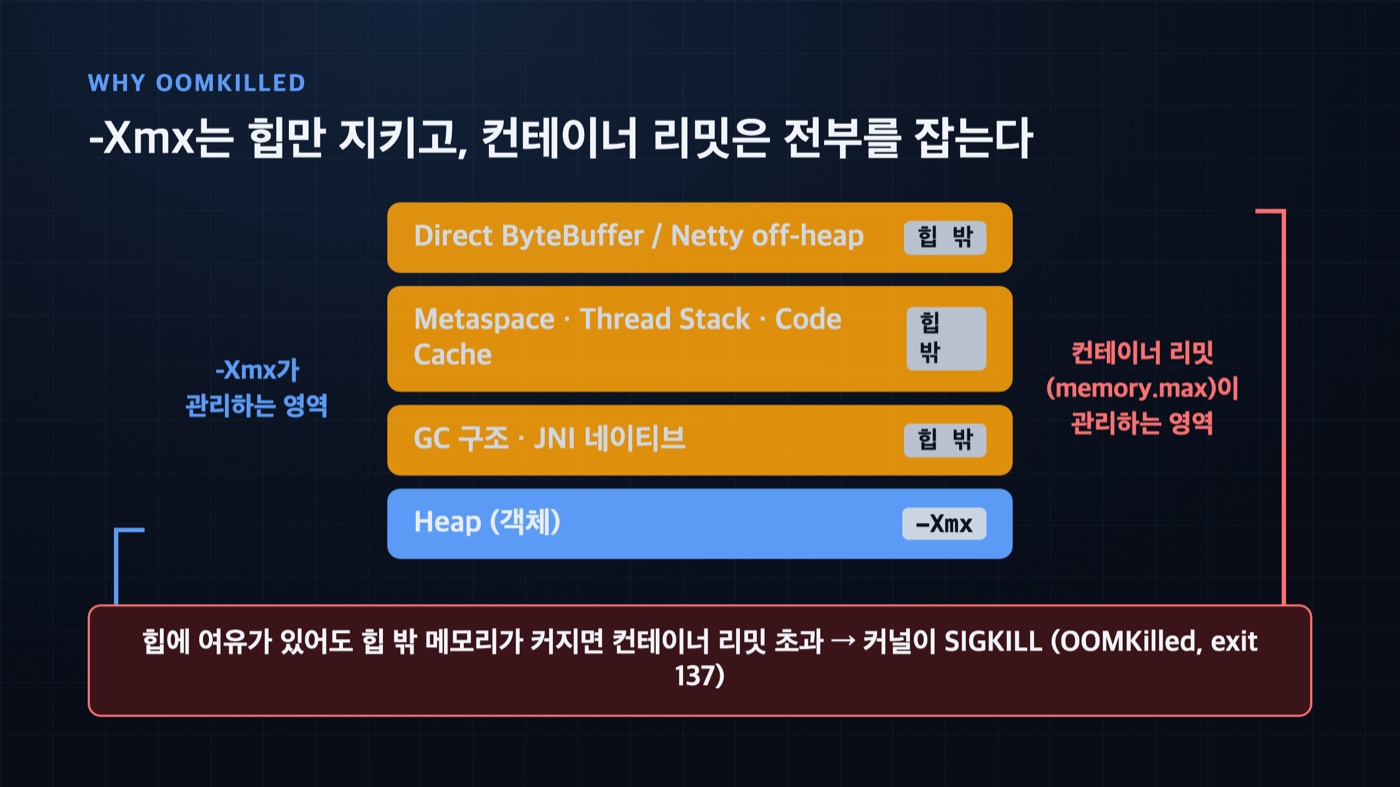
OOMKilled는 JVM이 아니라 리눅스 커널이 내린 판정이다. 컨테이너가 쓰는 전체 메모리가 cgroup의 하드 리밋(memory.max, 곧 limits.memory)을 넘는 순간 커널의 OOM Killer가 프로세스에 SIGKILL을 보내고, 파드는 종료 코드 137(128 + 9)로 죽는다. 문제는 JVM이 지키는 건 힙(-Xmx) 하나뿐이라는 점이다. 힙 밖 메모리는 힙 사용량에 안 잡히지만 컨테이너 리밋에는 고스란히 더해진다.
JVM 프로세스가 실제로 소비하는 메모리는 대략 이렇게 나뉜다.
| 메모리 영역 | -Xmx에 포함되나 | 컨테이너 리밋에 잡히나 |
|---|---|---|
| Heap (객체) | O | O |
| Metaspace (클래스 메타데이터) | X | O |
| Thread Stack (스레드당 | X | O |
| Code Cache (JIT 컴파일 코드) | X | O |
| Direct ByteBuffer / Netty off-heap | X | O |
| GC 내부 구조·네이티브 라이브러리(JNI) | X | O |
표에서 보듯 힙을 뺀 나머지가 전부 “힙에는 안 잡히지만 컨테이너 리밋에는 잡히는” 영역이다. 스레드를 수백 개 띄우는 서비스나 Netty 기반 통신, 대용량 Direct ByteBuffer를 쓰는 워크로드에서는 이 non-heap 영역이 수백 MB로 불어난다. 그래서 힙 그래프는 평온한데 파드는 죽는 전형적인 상황이 벌어진다.
여기서 헷갈리기 쉬운 게 OOMKilled와 java.lang.OutOfMemoryError의 차이다. 둘은 완전히 다른 사건이다.
| 구분 | OOMKilled (Exit 137) | java.lang.OutOfMemoryError |
|---|---|---|
| 주체 | 리눅스 커널 OOM Killer | JVM 자체 |
| 원인 | 컨테이너 전체 메모리 > memory.max | 힙(또는 metaspace 등) 논리적 한계 초과 |
| 증상 | 프로세스 즉시 SIGKILL, 스택 트레이스 없음 | 예외 발생, 로그에 스택 트레이스 남음 |
| 확인 위치 | kubectl describe pod의 State/Reason | 애플리케이션 로그 |
즉 로그에 아무 예외도 없이 파드만 재시작됐다면 십중팔구 OOMKilled이고, 이건 힙 튜닝이 아니라 컨테이너 메모리 회계의 문제다. Sysdig의 OOM 트러블슈팅 정리도 같은 지점을 지적한다. 원인을 여기까지 좁혔다면 이제 컨테이너 메모리가 어떤 knob으로 관리되는지 봐야 한다.
컨테이너 메모리의 진짜 지도 — requests, limits, 그리고 cgroup
파드 메모리를 이해하는 출발점은 requests와 limits가 서로 다른 일을 한다는 사실이다. requests.memory는 스케줄러가 노드를 고를 때 쓰는 예약량이고, limits.memory는 컨테이너가 절대 넘을 수 없는 상한이다. 이 상한이 그대로 cgroup v2의 memory.max로 내려간다. 그리고 이 둘의 조합이 파드의 QoS 클래스를 결정한다.
Kubernetes는 파드를 세 QoS 클래스로 나눈다(공식 문서). Guaranteed는 모든 컨테이너가 requests == limits인 경우로, 메모리 압박이 오면 가장 늦게 회수되고 가장 늦게 죽는다. Burstable은 requests < limits라 평소엔 requests만큼 보장받되 여유가 있으면 limits까지 당겨 쓴다. BestEffort는 requests도 limits도 없어 노드가 쪼들리면 가장 먼저 죽는다.
문제는 1.37 이전까지 이 구조가 “리밋을 넘으면 즉시 사살” 외에 다른 완충 장치가 없었다는 데 있다. limits.memory를 512Mi로 잡아 두면 513Mi가 되는 순간 경고도, 유예도 없이 OOMKill이다. 커널이 회수(reclaim) 압력을 미리 걸어 프로세스 속도를 늦춰 주는 중간 단계가 없었다. Memory QoS가 채우려는 게 바로 이 빈칸이다.
Memory QoS가 바꾸는 것 — OOMKill 직전에 브레이크를 거는 법
Memory QoS는 cgroup v2의 세밀한 메모리 knob(memory.min, memory.low, memory.high)을 채워서, 하드 리밋(memory.max)에 닿기 전에 커널이 회수 압력을 먼저 걸도록 만드는 기능이다. 결과적으로 “리밋 초과 → 즉시 사살”이던 흐름이 “임계 초과 → throttle·reclaim → 그래도 안 되면 사살”로 바뀐다. Kubernetes 1.22에서 Alpha로 나와 1.36에서 계층형 보호가 추가됐고, 1.37에서 Beta로 승격했다. 단, cgroup v2를 쓰는 리눅스 노드에서만 동작한다.
각 knob이 하는 일은 뚜렷하게 구분된다.
| cgroup v2 knob | 역할 | 초과 시 동작 |
|---|---|---|
memory.min | 회수 불가 보호선 | 이 아래로는 절대 회수 안 함 (노드 압박 시 보호) |
memory.low | best-effort 보호선 | 다른 회수 대상이 없을 때만 회수 |
memory.high | throttle 임계 | 초과 시 강한 reclaim + 프로세스 throttle (죽이진 않음) |
memory.max | 하드 리밋 | 초과 시 OOMKill |
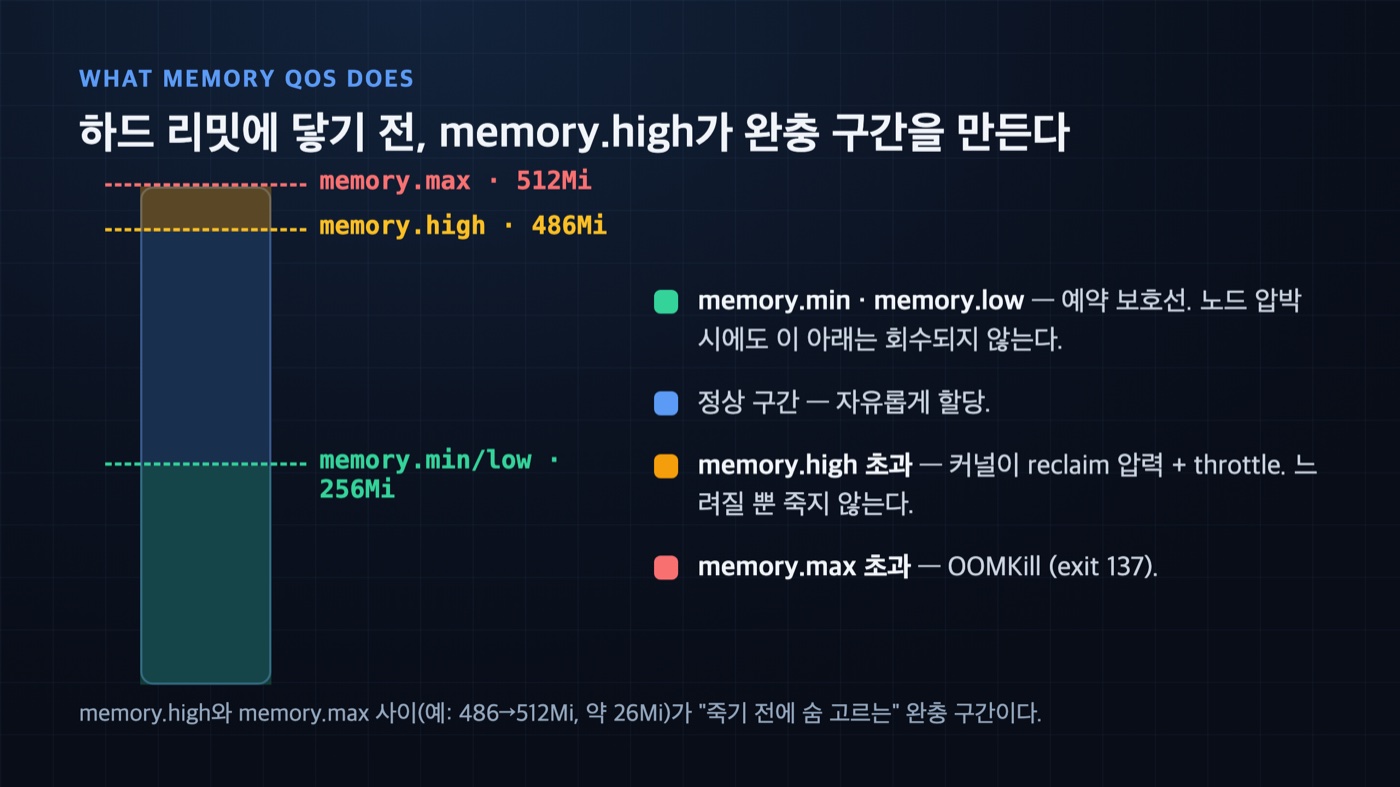
핵심은 memory.high와 memory.max 사이에 “완충 구간”이 생긴다는 점이다. 사용량이 memory.high를 넘으면 커널은 그 cgroup에 집중적으로 reclaim을 걸고 할당을 느리게 만든다. 이때 프로세스는 느려질 뿐 죽지 않는다. 반면 memory.max는 여전히 넘으면 죽는 하드 리밋이다. Memory QoS는 이 memory.high를 자동으로 채워 넣어 “죽기 전에 숨 고를 시간”을 벌어 준다.
값이 어떻게 계산되는지는 KEP-2570에 정의돼 있다. memory.min은 메모리 요청량을 보호선으로 그대로 쓴다.
# Guaranteed 컨테이너: 요청량 전체를 회수 불가로 보호
memory.min = requests.memory

# Burstable 컨테이너: 같은 값을 memory.low(best-effort 보호)로 설정
memory.low = requests.memory

# memory.high: throttle 임계값
memory.high = floor[(requests.memory
              + memoryThrottlingFactor * ((limits.memory or node allocatable) - requests.memory))
/ pageSize] * pageSizememory.min은 requests 값을 그대로 써서, 노드 전체가 메모리 압박을 받아도 이 파드의 예약분만큼은 커널이 회수하지 못하게 못 박는다. memory.high는 requests와 limits 사이를 memoryThrottlingFactor(0 초과 1.0 이하) 비율로 나눈 지점에 throttle 선을 긋는다. 여기서 중요한 단서가 하나 있다. memory.high는 오버커밋이 일어나는 Burstable·BestEffort 컨테이너에만 설정된다. Guaranteed는 requests == limits라 공식에 넣으면 결과가 곧 memory.max가 되어 완충 구간이 0이므로, 커널이 memory.high를 아예 걸지 않는다. 리밋이 없는 컨테이너는 limits 대신 노드 allocatable을 넣어 계산하고, 마지막에 pageSize 단위로 내림 정렬한다. memory.max는 예전과 동일하게 limits.memory가 그대로 매핑되므로 하드 리밋 자체는 바뀌지 않는다.
실제 숫자를 넣어 보면 감이 온다. requests를 256Mi, limits를 512Mi로 잡고 memoryThrottlingFactor를 0.9로 뒀다면, memory.high는 256 + 0.9 × (512 − 256) = 256 + 230.4 ≈ 486Mi 지점에 걸린다. 사용량이 486Mi를 넘는 순간 커널이 reclaim을 걸기 시작하고, 512Mi(memory.max)에 닿기 전 약 26Mi가 완충 지대가 된다. factor를 0.8로 낮추면 이 선이 461Mi로 내려와 완충 구간이 51Mi로 넓어진다. 즉 factor는 “얼마나 일찍 브레이크를 밟을 것인가”를 정하는 손잡이인 셈이다.
여기서 “힙을 줄이는 쪽과 컨테이너가 관리하는 쪽”을 함께 보면 그림이 완성된다. JVM 안에서 객체 헤더나 GC로 힙을 줄이는 접근은 JDK 27 신기능 총정리에서 다룬 Compact Object Headers 같은 변화이고, 컨테이너 바깥에서 메모리를 관리하는 접근이 바로 이 Memory QoS다. 두 축이 맞물려야 파드가 안 죽는다.
기본값의 함정 — feature gate는 켜졌는데 왜 아무 일도 안 일어나나
feature gate가 켜져도 아무 일이 안 일어나는 이유는 kubelet의 memoryThrottlingFactor 기본값이 nil이기 때문이다. 1.37에서 MemoryQoS feature gate는 Beta로 기본 활성화되지만, 이 값이 nil이면 kubelet은 어떤 컨테이너에도 memory.high를 쓰지 않는다. 그래서 게이트는 켜졌는데 cgroup 파일의 memory.high는 여전히 max로 비어 있는 상황이 벌어진다(공식 1.37 블로그).
놓치기 쉬운 게 하나 더 있다. throttle(memory.high)과 reservation(memory.min·memory.low)은 서로 다른 필드가 제어한다. memoryThrottlingFactor는 memory.high만 담당하고, memory.min(Guaranteed)·memory.low(Burstable) 예약 보호는 별도 필드인 memoryReservationPolicy가 맡는다. 이 필드는 1.36에서 throttle과 분리돼 들어왔고 기본값이 None이라, TieredReservation으로 바꾸지 않으면 예약 보호선은 아예 써지지 않는다(KEP-2570).
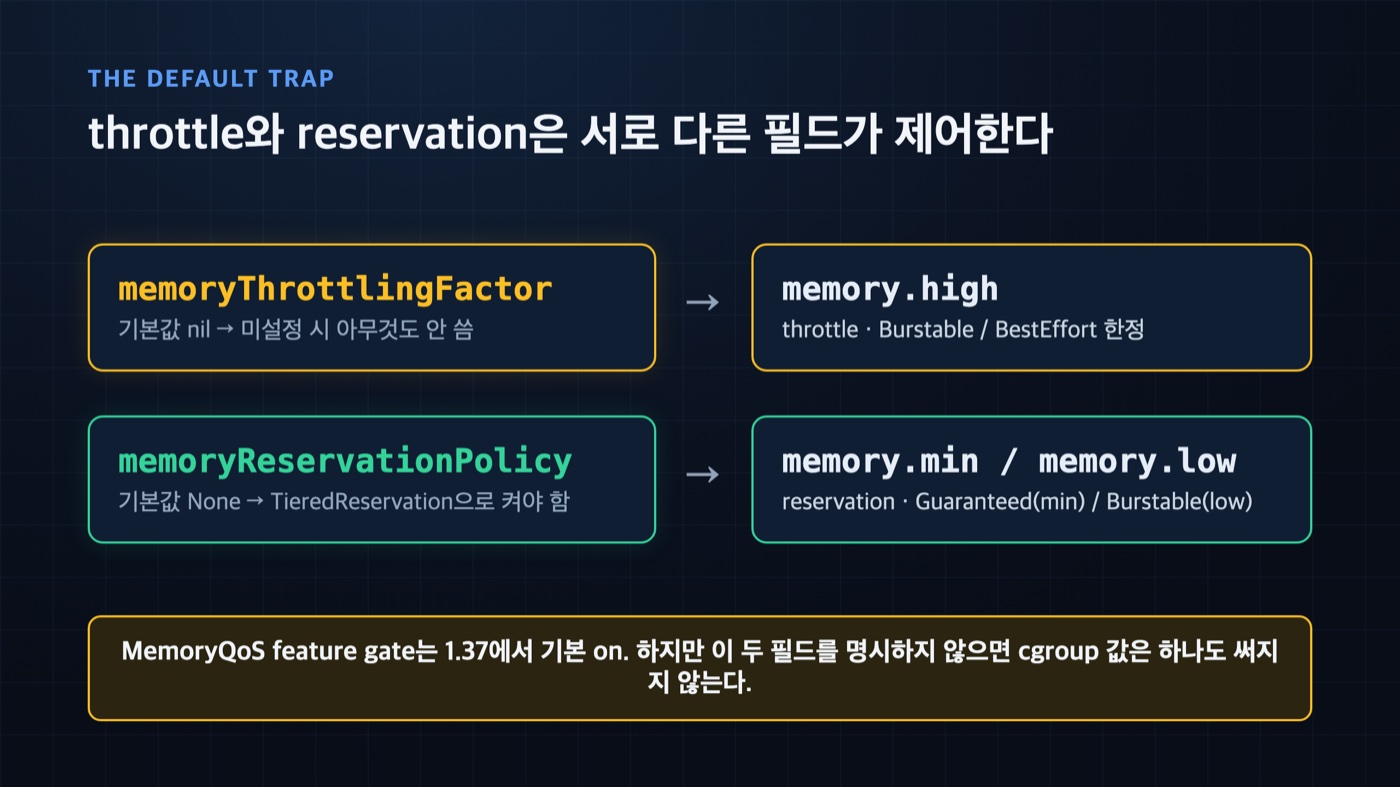
정리하면 1.37의 모든 kubelet은 feature gate가 켜진 채 배포되지만, 두 필드가 모두 비어 있으면 어떤 cgroup 값도 건드리지 않는다. 이건 의도된 안전 장치다. 예전 Alpha 시절에는 memoryThrottlingFactor가 0.9로 기본 설정돼 있어서, feature gate를 켜는 것만으로 kubelet이 모든 컨테이너에 memory.high를 자동으로 걸었다. 이게 예기치 못한 throttle을 유발할 수 있어, Beta 승격 과정에서 기본값을 nil로 바꿔 “명시적으로 켜야만 동작하는” 방식으로 안전하게 전환한 것이다.
그래서 Memory QoS를 실제로 켜려면 kubelet 설정에 값을 직접 넣어야 한다.
# /var/lib/kubelet/config.yaml (KubeletConfiguration)
apiVersion: kubelet.config.k8s.io/v1beta1
kind: KubeletConfiguration
# MemoryQoS는 1.37에서 기본 on이지만, 아래 두 필드를 넣어야 실제로 값이 써진다.
memoryThrottlingFactor: 0.9                  # memory.high(throttle) — Burstable/BestEffort에 적용
memoryReservationPolicy: TieredReservation # memory.min/low(reservation) 활성화이 설정을 노드에 반영하고 kubelet을 재시작해야 비로소 값이 채워진다. memoryThrottlingFactor: 0.9는 requests에서 limits까지 구간의 90% 지점에 memory.high throttle 선을 그으라는 뜻이고, memoryReservationPolicy: TieredReservation은 requests만큼을 memory.min(Guaranteed)·memory.low(Burstable)로 예약 보호하라는 뜻이다. 두 필드는 독립적이라 한쪽만 켤 수도 있다. throttle factor를 낮출수록(예: 0.8) throttle이 더 일찍 걸려 안전하지만 성능 여유가 줄고, 높일수록 하드 리밋에 가까워질 때까지 버틴다. feature gate만 믿고 이 값들을 빼먹으면 Memory QoS는 사실상 꺼져 있는 것과 같다.
실제로 켜고 확인하기 — kubelet 설정부터 cgroup 파일 검증까지
설정이 실제로 먹었는지는 추측하지 말고 cgroup 파일을 직접 열어 확인해야 한다. cgroup v2 노드에서는 컨테이너 안에서 /sys/fs/cgroup/에 자기 cgroup이 그대로 마운트되므로, kubectl exec로 들어가 memory.high, memory.max, memory.current, memory.events를 읽으면 Memory QoS가 값을 채웠는지 바로 드러난다.
먼저 검증에 쓸 파드를 Burstable 클래스로 하나 띄운다. memory.high throttle은 Burstable·BestEffort에만 걸리므로, 완충 구간을 눈으로 확인하려면 requests < limits인 Burstable이라야 한다.
# memory-qos-demo.yaml
apiVersion: v1
kind: Pod
metadata:
  name: memory-qos-demo
spec:
  containers:
  - name: app
    image: eclipse-temurin:21-jre
    command: ["sleep", "3600"]
    resources:
      requests:
        memory: "256Mi"   # requests < limits → Burstable QoS
      limits:
memory: "512Mi" # 이 값이 cgroup memory.max로 내려간다requests를 256Mi, limits를 512Mi로 다르게 잡았으므로 이 파드는 Burstable 클래스가 된다. 이때 kubelet은 requests(256Mi)를 memory.low로, limits(512Mi)를 memory.max로 매핑하고, 그 사이 90% 지점(≈486Mi)에 memory.high를 계산해 넣는다. 앞의 산수 예시와 정확히 같은 값이다. 이미지는 non-heap 실험까지 이어갈 수 있게 JRE가 들어간 eclipse-temurin:21-jre로 잡았다.
이제 실제 cgroup 값을 읽어 본다.
# QoS 클래스 확인 (Burstable로 나와야 한다)
kubectl get pod memory-qos-demo -o jsonpath='{.status.qosClass}{"\n"}'

# 컨테이너 내부에서 cgroup v2 메모리 knob 직접 확인
kubectl exec memory-qos-demo -- sh -c '
  echo "memory.max  = $(cat /sys/fs/cgroup/memory.max)";
  echo "memory.high = $(cat /sys/fs/cgroup/memory.high)";
  echo "memory.low  = $(cat /sys/fs/cgroup/memory.low)";
  echo "memory.current = $(cat /sys/fs/cgroup/memory.current)";
'memory.max는 512Mi에 해당하는 바이트(536870912)로 찍힌다. memory.low는 memoryReservationPolicy: TieredReservation을 켰다면 requests와 같은 256Mi(268435456)로 나온다. 핵심은 memory.high다. memoryThrottlingFactor를 설정했다면 486Mi 부근의 실제 숫자가 찍히고, 빠뜨렸다면 max라는 문자열이 그대로 나온다. memory.high가 max로 보인다면 앞 절의 두 필드 중 하나를 빠뜨린 것이다. 참고로 이 파드가 Burstable이 아니라 Guaranteed(requests == limits)였다면 memory.high는 정상 설정에서도 max로 남는다. throttle 대상이 아니기 때문이다.
throttle이 실제로 걸렸는지는 memory.events가 증거를 남긴다.
kubectl exec memory-qos-demo -- cat /sys/fs/cgroup/memory.events
# high 12      <- memory.high를 넘어 throttle된 횟수
# max 0        <- memory.max에 부딪힌 횟수
# oom 0
# oom_kill 0 <- 실제 OOMKill 횟수 (0이면 안 죽었다는 뜻)memory.events의 high 카운터가 올라가는데 oom_kill이 0이라면, 사용량이 임계를 넘었지만 커널이 reclaim으로 버텨 파드를 죽이지 않았다는 뜻이다. Memory QoS가 노리는 정확히 그 그림이다. 반대로 Memory QoS 없이 같은 부하를 주면 high는 안 움직이고 oom_kill이 1로 튀며 파드가 재시작된다. 이 두 숫자의 차이가 Memory QoS의 효과를 가장 직접적으로 보여 준다.
사이드카가 리밋을 잡아먹을 때 — Pod-Level Resource Managers
멀티 컨테이너 파드에서는 컨테이너별로 리밋을 잡는 방식이 잘 안 맞는다. 애플리케이션 컨테이너 옆에 로그 수집·프록시 사이드카가 붙으면 파드 전체가 쓸 메모리를 컨테이너마다 나눠 예측하기 어렵다. 파드 단위로 requests/limits를 선언하는 .spec.resources 필드 자체는 Kubernetes 1.34에서 먼저 도입됐다. 1.37에서 Beta로 승격한 것은 이 파드 레벨 선언을 kubelet의 Topology·CPU·Memory Manager가 배치 결정에 직접 활용하는 통합, 즉 Pod-Level Resource Managers다(1.36 Alpha에서 1.37 Beta로). 이 통합은 기본 off라 feature gate로 명시적으로 켜야 한다.
파드 레벨과 컨테이너 레벨을 함께 쓰는 형태는 이렇다.
apiVersion: v1
kind: Pod
metadata:
  name: pod-level-demo
spec:
  resources:                 # 파드 전체가 쓸 수 있는 총량
    requests:
      memory: "512Mi"
    limits:
      memory: "512Mi"
  containers:
  - name: app
    image: myapp:latest
    resources:
      requests:
        memory: "384Mi"      # 개별 컨테이너는 파드 총량 안에서 나눠 쓴다
      limits:
        memory: "448Mi"
  - name: sidecar
    image: log-collector:latest
# 사이드카는 개별 리밋을 생략하고 파드 총량을 공유해도 된다파드 레벨 resources가 512Mi 상한을 잡고, 그 안에서 개별 컨테이너가 각자 몫을 나눠 쓴다. 사이드카처럼 소비량이 들쭉날쭉한 컨테이너는 개별 리밋을 생략하고 파드 총량을 공유하게 두는 편이 낫다. 이렇게 하면 kubelet의 Topology Manager·CPU Manager·Memory Manager가 파드 단위 총량을 기준으로 배치를 결정하고, QoS 클래스도 파드·컨테이너 리소스를 함께 보고 판정한다. Memory QoS와도 상보적으로 맞물려, 파드 총량 기준으로도 cgroup 계층에 보호선을 그을 수 있다.
기능을 켜는 건 다른 feature gate와 동일하다.
# 통합 매니저 기능은 kubelet에서 켠다
--feature-gates=PodLevelResources=true파드 레벨 resources 선언이 배치 결정에 실제로 반영되려면 kubelet에서 이 게이트가 활성화돼 있어야 한다. 게이트를 켜지 않으면 매니페스트는 통과해도 매니저가 파드 단위 총량을 무시하므로 조용히 넘어가는 함정이 생긴다. Pod-Level Resource Managers는 Memory QoS와 짝으로 쓸 때 특히 값어치가 커진다. Memory QoS가 개별 cgroup에 완충을 만든다면, 이쪽은 그 완충을 파드 전체 예산 위에서 계산하게 해 준다.
JVM 쪽에서도 해야 할 일 — MaxRAMPercentage와 non-heap 여유
Memory QoS를 켰다고 JVM 설정을 방치하면 안 된다. 컨테이너 리밋을 전부 힙에 몰아주면 non-heap이 들어설 자리가 없어 여전히 OOMKilled가 난다. 핵심은 리밋의 100%가 아니라 일부만 힙에 주고 나머지를 metaspace·스레드 스택·off-heap 몫으로 남기는 것이다. JDK는 -XX:MaxRAMPercentage로 이 비율을 조절하고, 컨테이너 인식(UseContainerSupport)은 JDK 10 이후 기본 on이라 cgroup 리밋을 알아서 읽는다.
문제는 -XX:MaxRAMPercentage의 기본값이 25%로 보수적이라는 점이다. 512Mi 리밋이면 힙이 128MB밖에 안 잡혀 힙이 부족해지기 쉽다. 그래서 워크로드에 맞게 명시적으로 올려 준다.
# Deployment에서 JVM 옵션 주입 예시
env:
- name: JAVA_TOOL_OPTIONS
  value: >-
    -XX:MaxRAMPercentage=70.0
    -XX:MaxMetaspaceSize=128m
-XX:MaxDirectMemorySize=64mMaxRAMPercentage=70.0은 컨테이너 리밋의 70%를 힙 상한으로 삼으라는 뜻이다. 512Mi 리밋이면 힙은 약 358MB가 되고, 남은 30%가 metaspace·스레드·off-heap 몫이 된다. MaxMetaspaceSize와 MaxDirectMemorySize로 힙 밖 영역에도 상한을 걸어 두면, 그 영역이 무한정 커져 컨테이너를 밀어내는 사고를 막을 수 있다. off-heap 사용량이 큰 서비스라면 힙 비율을 50%까지도 낮춘다. 실무에서는 컨테이너 리밋을 목표 힙 크기에 256~512MB 버퍼를 더한 값으로 잡는 방식이 자주 쓰인다. 힙을 먼저 정하고 non-heap 버퍼를 그 위에 얹는 순서다.
힙 밖 메모리가 왜 위험한지는 바로 다음 절에서 실제 컨테이너로 재현한다. Direct ByteBuffer로 수백 MB를 할당해도 힙 사용량은 수십 MB에 머무는데, 바로 이 간극이 “힙은 멀쩡한데 파드는 OOMKilled” 현상의 정체다. 컨테이너 리밋이 이 off-heap 증가분을 감당하지 못하면, 힙 그래프가 평온해도 커널은 컨테이너를 사살한다. 그래서 JVM 튜닝과 컨테이너 리밋은 항상 함께 맞춰야 한다. 이 부분은 시작 시간과 메모리를 함께 다룬 Spring Boot 시작 시간 최적화 글과 이어서 보면 도움이 된다.
Memory QoS vs 기존 대안 — 무엇을 언제 쓰나
Memory QoS는 만능이 아니라 “죽기 전 완충”을 담당하는 한 겹이다. 리밋만 거는 방식, VPA, 파드 레벨 리소스 등 다른 도구와 역할이 겹치지 않으므로 함께 써야 한다. 어떤 문제에 무엇을 쓰는지 정리하면 다음과 같다.
| 접근 | 해결하는 문제 | 한계 |
|---|---|---|
limits.memory만 | 하드 상한으로 노드 보호 | 초과 시 즉시 OOMKill, 완충 없음 |
Memory QoS (memory.high) | OOMKill 직전 throttle·reclaim으로 완충 | cgroup v2 필수, memoryThrottlingFactor 명시 필요, Burstable·BestEffort 한정 |
Memory QoS (memory.min/low) | 노드 압박 시 파드 예약분 보호 | memoryReservationPolicy: TieredReservation 명시 필요, 과도하면 노드 오버커밋 위험 |
| Pod-Level Resource Managers | 사이드카·멀티 컨테이너 총량 회계 | Beta·기본 off, kubelet feature gate 활성화 필요 |
| VPA (Vertical Pod Autoscaler) | requests/limits 값 자체를 자동 추천·조정 | 재시작 동반, Memory QoS와 목적이 다름 |
JVM MaxRAMPercentage 튜닝 | 힙/non-heap 분배로 OOMKill 예방 | 컨테이너 밖에서는 못 막는 영역 존재 |
표에서 보듯 Memory QoS와 JVM 튜닝은 대체재가 아니라 보완재다. JVM 쪽에서 non-heap 여유를 확보하고, 컨테이너 쪽에서 Memory QoS로 완충을 두는 식으로 층을 쌓아야 한다. 다만 Memory QoS에도 분명한 한계가 있다. memory.high는 커널 reclaim에 의존하는데, 회수할 페이지가 마땅치 않으면(특히 swap이 꺼진 노드에서) throttle이 걸린 채 결국 memory.max에 도달해 OOMKill로 이어질 수 있다. 또 cgroup v2가 아닌 노드에서는 아예 동작하지 않고, memory.min을 크게 잡으면 그 파드는 보호되지만 노드 전체 메모리가 쪼들릴 수 있다. 이 기능은 1.37에서 Beta인 만큼, 노드 전면 적용 전에 카나리 노드에서 memory.events를 관측하며 값을 조정하는 편이 안전하다. Kubernetes 1.37 전반의 다른 변화는 Kubernetes 1.37 Garhwal 핵심 변화 글에서 함께 정리했다.
로컬 컨테이너로 직접 재현하기 — 죽는 화면과 사는 화면
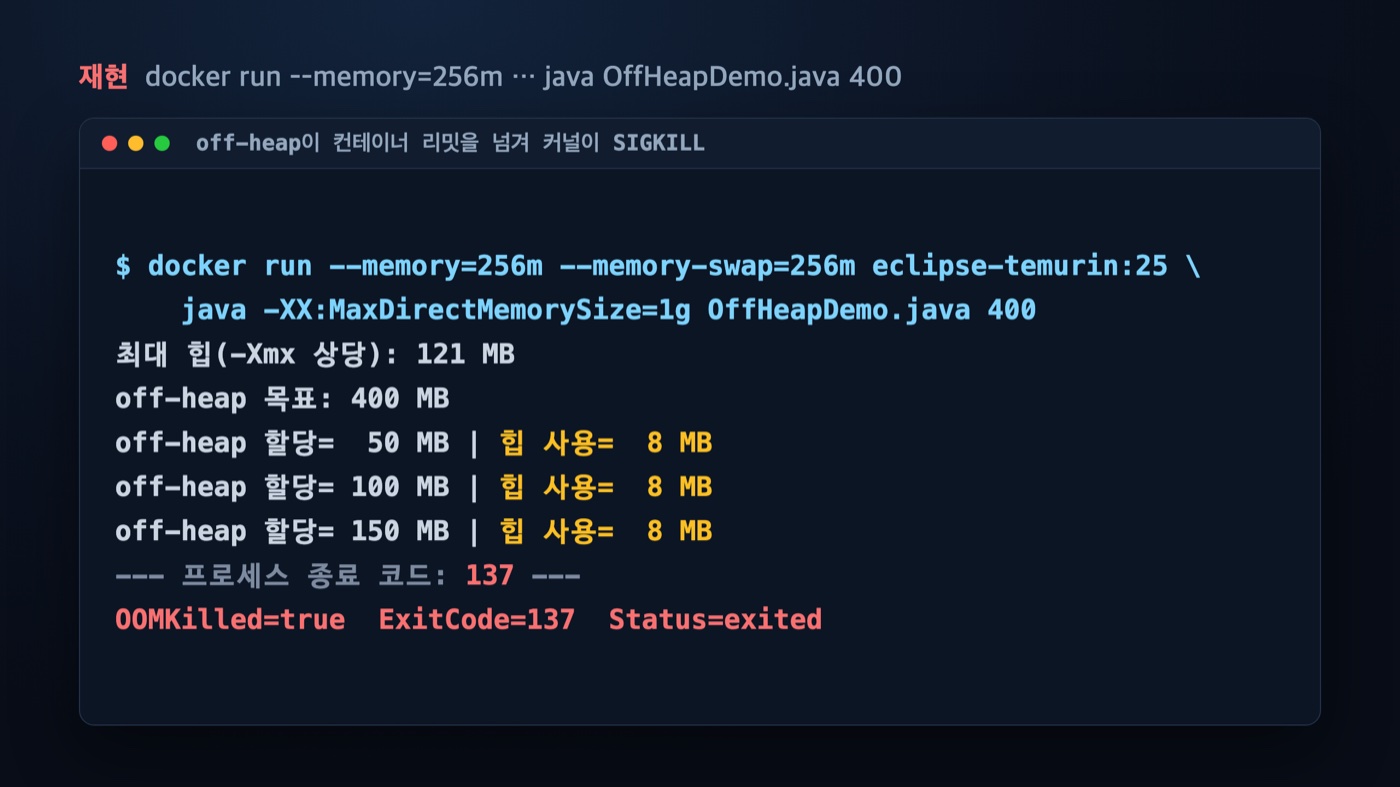
지금까지의 이야기는 로컬 Docker 컨테이너 하나로 그대로 재현된다. cgroup v2가 켜진 환경에서 메모리 리밋을 좁게 준 컨테이너에 힙 밖(Direct ByteBuffer) 메모리를 계속 할당하면, 힙 사용량은 8MB로 낮은데도 컨테이너가 OOMKilled(exit 137)로 죽는다. 반대로 리밋을 non-heap까지 고려해 키우면 같은 워크로드가 죽지 않고 완료된다. 아래는 실제로 실행해 캡처한 화면이다.
먼저 힙 밖 메모리를 점진적으로 늘리는 완결 예제다.
import java.nio.ByteBuffer;
import java.util.ArrayList;
import java.util.List;

public class OffHeapDemo {
    public static void main(String[] args) {
        int targetMb = args.length > 0 ? Integer.parseInt(args[0]) : 400;
        Runtime rt = Runtime.getRuntime();
        System.out.printf("최대 힙(-Xmx 상당): %d MB%n", rt.maxMemory() / (1024 * 1024));
        System.out.printf("off-heap 목표: %d MB%n", targetMb);

        List<ByteBuffer> offHeap = new ArrayList<>();
        for (int i = 1; i <= targetMb; i++) {
            ByteBuffer buf = ByteBuffer.allocateDirect(1024 * 1024); // 1MB off-heap
            while (buf.hasRemaining()) {
                buf.put((byte) 1); // 페이지를 실제로 커밋시켜 컨테이너 RSS에 반영
            }
            offHeap.add(buf);
            long usedHeapMb = (rt.totalMemory() - rt.freeMemory()) / (1024 * 1024);
            if (i % 50 == 0 || i == targetMb) {
                System.out.printf("off-heap 할당=%4d MB | 힙 사용=%3d MB%n", i, usedHeapMb);
            }
        }
        System.out.printf("완료: off-heap %d MB 확보, 힙은 여전히 낮음%n", offHeap.size());
    }
}이 프로그램은 ByteBuffer.allocateDirect로 1MB짜리 Direct ByteBuffer를 목표치만큼 할당하고, 각 버퍼를 실제로 채워(put) 커널이 물리 페이지를 커밋하게 만든다. Direct ByteBuffer는 힙이 아니라 네이티브 메모리에 잡히므로, 출력의 “힙 사용” 값은 낮게 유지되는데 컨테이너 전체 메모리(cgroup memory.current)는 계속 커진다. 이 간극이 OOMKilled의 정체다.
이제 메모리 리밋을 256Mi로 좁게 준 컨테이너에서 off-heap 400MB를 할당해 본다. JVM이 먼저 direct buffer 예외를 던지지 않도록 -XX:MaxDirectMemorySize를 넉넉히 잡아, 컨테이너 cgroup 리밋 초과로 커널이 죽이도록 유도한다.
docker run --name oom-repro --memory=256m --memory-swap=256m \
  -v "$PWD":/app -w /app eclipse-temurin:25 \
  java -XX:MaxDirectMemorySize=1g OffHeapDemo.java 400
docker inspect oom-repro --format 'OOMKilled={{.State.OOMKilled}} ExitCode={{.State.ExitCode}}'위 명령을 실행하면 힙 사용은 8MB로 평온한데 off-heap이 150MB를 넘어서자마자 컨테이너가 종료 코드 137로 죽고, OOMKilled=true가 찍힌다. 로그에 아무 예외도 없이 커널이 프로세스를 사살한 것이다.
해결은 리밋을 힙 밖 메모리까지 감안해 키우는 것이다. 같은 워크로드를 리밋 768Mi에 올리고, -XX:MaxRAMPercentage=60.0으로 힙을 리밋의 60%로 제한해 non-heap 몫을 남긴다.
docker run --name mem-fixed --memory=768m --memory-swap=768m \
  -v "$PWD":/app -w /app eclipse-temurin:25 \
  java -XX:MaxRAMPercentage=60.0 -XX:MaxDirectMemorySize=512m OffHeapDemo.java 400
docker inspect mem-fixed --format 'OOMKilled={{.State.OOMKilled}} ExitCode={{.State.ExitCode}}'이번에는 off-heap 400MB를 전부 할당하고도 완료가 찍히며 종료 코드 0, OOMKilled=false로 정상 종료한다. 리밋 안에 힙과 non-heap이 모두 들어갈 자리를 마련해 준 덕분이다.
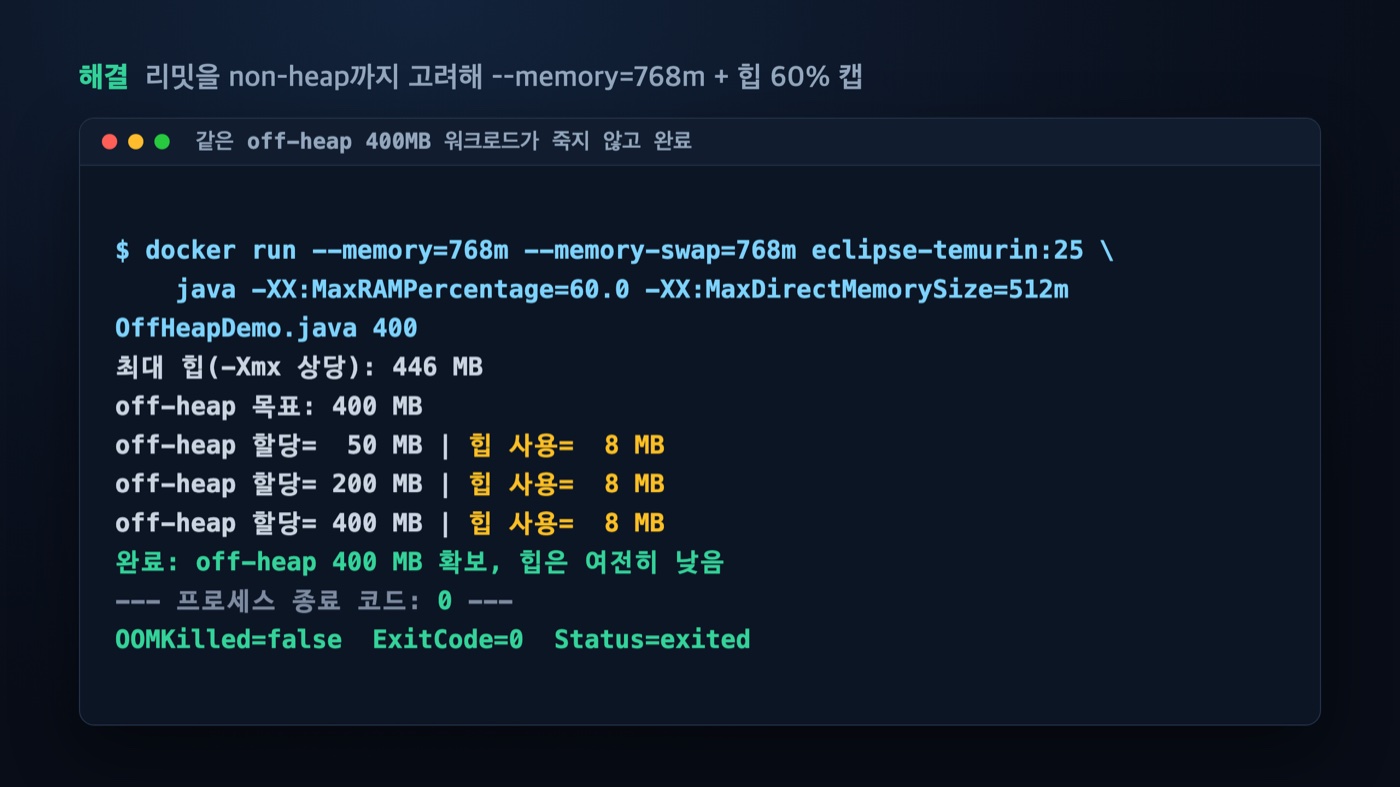
이 로컬 데모가 보여 주는 건 해결의 절반, 곧 리밋 크기 조정(JVM 튜닝) 쪽이다. 실제 클러스터에서 Memory QoS는 나머지 절반을 맡는다. 하드 리밋에 닿기 전 memory.high로 throttle을 걸어, 조용한 즉시 사살 대신 완충과 memory.events 신호를 남기는 일을 kubelet이 자동으로 해 준다. 다만 위 예제처럼 회수 불가능한 순수 off-heap이 계속 커지는 워크로드에서는 memory.high가 걸려도 reclaim할 페이지가 없어 결국 리밋에 도달할 수 있는데, 이건 앞서 짚은 Memory QoS의 한계와 정확히 같은 지점이다. 그래서 두 축, 즉 컨테이너 쪽 Memory QoS와 JVM 쪽 리밋 산정을 함께 맞춰야 한다.
FAQ
Memory QoS를 켜면 OOMKilled가 완전히 사라지나?
아니다. Memory QoS는 하드 리밋(memory.max)에 닿기 전에 memory.high로 throttle·reclaim을 거는 완충 장치일 뿐, 리밋 자체를 없애지 않는다. 커널이 회수할 메모리를 못 찾으면(특히 swap이 꺼진 노드) 여전히 OOMKill이 발생하므로, 실제 효과는 memory.events의 high와 oom_kill 카운터를 비교해 확인해야 한다.
memoryThrottlingFactor는 얼마로 설정해야 하나?
0 초과 1.0 이하 값이며, 낮출수록 throttle이 더 일찍 걸려 안전하지만 성능 여유가 줄고, 높일수록 하드 리밋에 가까워질 때까지 버틴다. 과거 Alpha 기본값이던 0.9에서 시작해 카나리 노드에서 memory.events를 관측하며 조정하는 방식을 권한다. 1.37에서는 기본값이 nil이라 이 값을 명시하지 않으면 memory.high throttle이 사실상 꺼져 있는 것과 같다.
cgroup v1 노드에서도 Memory QoS를 쓸 수 있나?
쓸 수 없다. Memory QoS는 cgroup v2의 memory.min, memory.low, memory.high knob에 의존하므로 cgroup v2를 쓰는 리눅스 노드에서만 동작한다. 노드가 cgroup v1이라면 커널·컨테이너 런타임을 cgroup v2 unified 계층으로 먼저 전환해야 한다.
Guaranteed와 Burstable 중 뭘 써야 하나?
메모리 예측이 명확하고 안정성이 중요한 워크로드는 requests == limits로 Guaranteed를 쓰는 편이 좋다. Guaranteed 파드는 (memoryReservationPolicy: TieredReservation을 켰다면) requests가 memory.min으로 보호되지만, 오버커밋이 없어 memory.high throttle 대상은 아니다. 반면 평소 소비량이 낮고 가끔 튀는 워크로드를 Burstable로 두면 memory.low 예약 보호와 memory.high throttle을 모두 받아 완충 효과를 볼 수 있다.
Pod-Level Resource Managers를 꼭 Memory QoS와 같이 켜야 하나?
필수는 아니지만 멀티 컨테이너·사이드카 파드라면 함께 쓰는 편이 낫다. 사이드카가 몇 MB를 쓸지 예측이 안 되는 상황에서 파드 총량으로 리밋을 잡아 두면, 그 총량을 기준으로 QoS 판정과 cgroup 보호선이 함께 계산된다. 단일 컨테이너 파드라면 Memory QoS만으로 충분하고, PodLevelResources는 Beta·기본 off라 별도 활성화가 필요하다는 점을 감안한다.
마치며
예전에 운영하던 서비스에서 힙 그래프는 종일 평온한데 새벽마다 파드가 조용히 재시작되는 일이 있었다. 로그에는 아무 예외도 없어서 한참을 헤맸고, 결국 kubectl describe의 Reason 한 줄(OOMKilled)과 종료 코드 137을 보고서야 힙이 아니라 컨테이너 회계 문제라는 걸 깨달았다. 원인은 배치 작업이 순간적으로 잡는 Direct ByteBuffer였고, 힙에는 잡히지 않으니 모니터링 대시보드가 전부 초록불이었던 것이다.
그때는 리밋을 키우고 MaxRAMPercentage를 낮춰 임시로 막았지만, Memory QoS가 있었다면 memory.high가 먼저 브레이크를 걸어 로그에 흔적이라도 남겼을 것이다. 1.37에서 이게 Beta로 올라온 건 반갑지만, feature gate만 켜면 되는 줄 알고 memoryThrottlingFactor를 빼먹는 실수는 나부터도 하기 쉬운 함정이다. 새 기능을 켤 때는 항상 cgroup 파일을 직접 열어 값이 실제로 채워졌는지 확인하는 습관이 결국 시간을 아껴 준다. 지금까지 Kubernetes Memory QoS와 Pod-Level Resource Managers를 파드 OOMKilled 관점에서 정리해 보았다.