이번 포스팅에서는 Spring AI 메모리를 단기 기억(ChatMemory)부터 파일 기반 장기 기억(AutoMemoryTools)까지 정리하고자 한다. LLM 애플리케이션에서 대화 맥락과 영구 기억을 각각 어떻게 붙이는지 두 층위로 다룬다. LLM은 기본적으로 직전 대화를 기억하지 못하는 stateless 모델이라, 같은 세션에서도 “방금 내 이름을 말했는데 왜 다시 묻지?” 같은 상황이 벌어진다. Spring AI는 이 문제를 두 층위로 푼다. 최근 대화를 유지하는 단기 기억과, 사용자의 사실·선호를 영구 저장하는 장기 기억이다. 여기서는 두 기억의 정확한 역할 차이, conversationId를 잡는 법, 대화가 길어질 때의 동작, 그리고 Claude Code의 메모리 구조를 꼭 닮은 AutoMemoryTools까지 실제 코드로 다룬다.
왜 LLM은 방금 한 말을 잊어버리나
LLM은 요청마다 완전히 독립적인 stateless 모델이라, 애플리케이션이 직접 과거 메시지를 다시 넣어 주지 않으면 직전 대화를 기억하지 못한다. Spring AI는 이 기억을 두 종류로 나눠 제공한다. 최근 몇 개의 메시지를 유지하는 단기 기억(ChatMemory)과, 사용자에 대한 사실을 영구 저장하는 장기 기억(AutoMemoryTools·VectorStore)이다. 이 둘은 저장 위치도, 수명도, 목적도 다르다.
Spring AI 공식 문서는 둘을 명확히 구분한다. ChatMemory는 “현재 대화의 맥락(relevant messages)”을 담는 작업 기억이고, 전체 대화 로그(chat history)는 Spring Data로 따로 저장하라고 안내한다(ChatMemory 공식 문서). 즉 Spring AI 메모리를 설계할 때 첫 질문은 “지금 대화만 이어지면 되는가, 아니면 재방문해도 나를 기억해야 하는가”다.
이 글의 코드는 Spring Boot 4.1.1, Java 21, Spring AI 2.0.1을 기준으로 한다. Spring AI는 2.1.0-M1부터 Spring Boot 4.2를 베이스라인으로 올렸지만(Spring AI 2.1.0-M1 릴리스 노트), 튜토리얼에서는 안정 버전인 2.0.1 GA를 쓴다. AI 코딩 에이전트의 영구 기억이 궁금하다면 claude-mem 영구 기억 튜토리얼과 이어서 보면 같은 아이디어가 프레임워크마다 어떻게 구현되는지 보인다.
Spring AI 메모리의 단기 기억 — ChatMemory로 대화 맥락 유지하기
단기 기억은 ChatMemory로 구현하며, 핵심 구현체는 최근 N개 메시지를 슬라이딩 윈도우로 유지하는 MessageWindowChatMemory다. MessageChatMemoryAdvisor에 물려 ChatClient에 붙이면, 매 요청마다 과거 메시지가 자동으로 프롬프트에 포함된다. 기본 윈도우 크기는 20개이고, 이를 식별하는 열쇠가 conversationId다.
가장 단순한 구성은 다음과 같다.
import org.springframework.ai.chat.client.ChatClient;
import org.springframework.ai.chat.client.advisor.MessageChatMemoryAdvisor;
import org.springframework.ai.chat.memory.ChatMemory;
import org.springframework.ai.chat.memory.MessageWindowChatMemory;
import org.springframework.ai.chat.model.ChatModel;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

@Configuration
public class ChatConfig {

    @Bean
    public ChatClient chatClient(ChatModel chatModel) {
        // 최근 20개 메시지를 유지하는 단기 기억
        ChatMemory chatMemory = MessageWindowChatMemory.builder()
                .maxMessages(20)
                .build();

        return ChatClient.builder(chatModel)
                .defaultSystem("너는 간결하게 답하는 백엔드 도우미다.")
                .defaultAdvisors(MessageChatMemoryAdvisor.builder(chatMemory).build())
                .build();
    }
}MessageWindowChatMemory가 대화 메시지를 20개까지 들고 있다가, 넘치면 오래된 것부터 버린다. 이걸 MessageChatMemoryAdvisor로 감싸 ChatClient의 기본 advisor로 등록하면, 이후 모든 prompt() 호출이 자동으로 과거 대화를 끌어와 LLM에 함께 보낸다. 별도 저장소를 지정하지 않으면 Spring AI가 InMemoryChatMemoryRepository를 기본으로 자동 구성한다(기본 윈도우 20개·자동 구성 동작은 ChatMemory 공식 문서에 정의돼 있다).
실제 호출부에서는 반드시 conversationId를 넘겨야 한다.
import org.springframework.ai.chat.memory.ChatMemory;
import org.springframework.web.bind.annotation.*;

@RestController
public class ChatController {

    private final ChatClient chatClient;

    public ChatController(ChatClient chatClient) {
        this.chatClient = chatClient;
    }

    @PostMapping("/chat")
    public String chat(@RequestParam String conversationId,
                       @RequestBody String message) {
        return chatClient.prompt()
                .user(message)
                // 이 대화를 식별하는 키 — 이 값으로 과거 메시지를 묶는다
                .advisors(a -> a.param(ChatMemory.CONVERSATION_ID, conversationId))
                .call()
                .content();
    }
}a.param(ChatMemory.CONVERSATION_ID, conversationId)가 이 요청을 특정 대화에 묶는 부분이다. 같은 conversationId로 다시 요청하면 앞서 주고받은 메시지가 윈도우 안에 남아 있어, “내 이름이 뭐라고 했지?” 같은 질문에 답할 수 있다. 이 값을 어떻게 잡느냐가 다음 절의 주제이자 가장 흔한 실수 지점이다.
conversationId를 잘못 잡으면 생기는 일
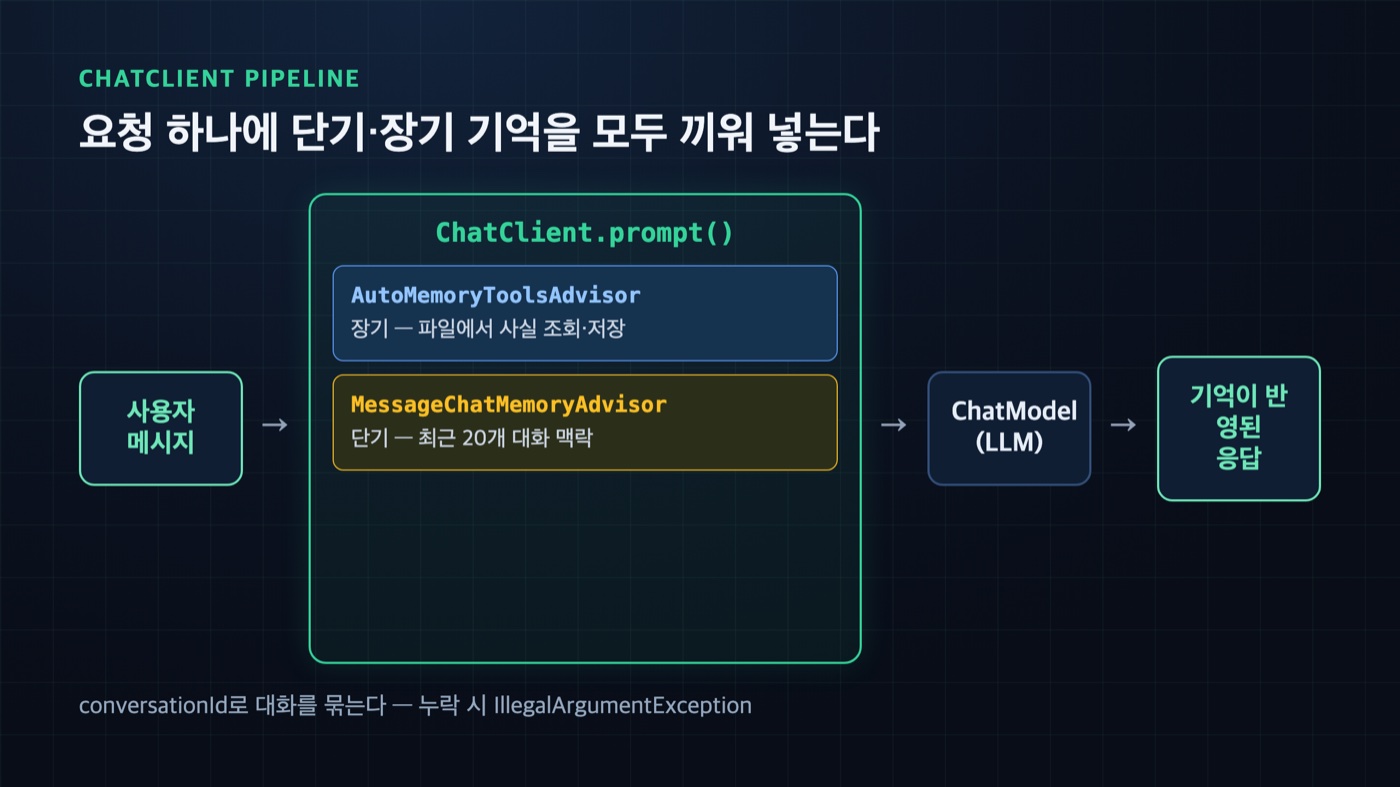
conversationId는 사용자나 세션별로 서버에서 파생해야 하며, 아예 넘기지 않으면 Spring AI가 런타임에 IllegalArgumentException을 던진다. 모든 사용자가 같은 고정값을 쓰면 서로의 대화가 섞이고, 반대로 매 요청 새 값을 쓰면 기억이 전혀 이어지지 않는다. 그래서 “사용자 식별자 + 세션”처럼 안정적이면서 사용자마다 구분되는 값을 서버에서 만들어야 한다.
공식 문서가 권하는 패턴은 클라이언트가 보낸 값을 그대로 믿지 말고 서버에서 조합하는 것이다(conversationId는 필수 파라미터로, 누락 시 예외가 난다).
// 사용자 ID와 세션 ID를 조합해 서버에서 파생한다
String conversationId = currentUser.getId() + ":" + httpSession.getId();

chatClient.prompt()
        .user(userInput)
        .advisors(a -> a.param(ChatMemory.CONVERSATION_ID, conversationId))
        .call()
.content();이렇게 하면 사용자 A와 B의 대화가 절대 섞이지 않고, 같은 사용자의 같은 세션 안에서는 기억이 유지된다. 대화 목록을 조회하거나 삭제할 때도 “현재 사용자에게 속한 conversationId”만 다뤄야 한다. 클라이언트가 보낸 conversationId를 검증 없이 쓰면 다른 사용자의 기억을 들여다보는 취약점이 되므로, 이 값은 항상 서버가 통제한다. conversationId 파라미터를 아예 빼면 IllegalArgumentException으로 요청이 실패하니, 테스트에서 빠르게 드러나는 편이다.
대화가 20개를 넘어가면 — 윈도우 eviction과 재시작 후 지속
MessageWindowChatMemory는 메시지가 상한을 넘으면 오래된 것부터 버리되, 대화 턴 경계를 지켜서 자른다. 그리고 Spring AI 메모리의 기본 저장소는 인메모리라, 애플리케이션을 재시작하면 기억이 사라진다. 재시작을 넘어 기억을 유지하려면 ChatMemoryRepository를 JDBC·Redis 같은 영속 저장소로 바꾸면 된다.
윈도우 eviction의 핵심은 “턴 경계 보존”이다. 20개째에서 잘라야 하는데 그 지점이 assistant 응답이나 tool 응답 중간이면, Spring AI는 다음 UserMessage까지 커서를 밀어 완결된 턴 단위로 자른다. 덕분에 “사용자 질문은 있는데 그에 대한 답이 잘려 나간” 어정쩡한 맥락이 생기지 않는다. SystemMessage는 eviction 대상에서 제외되어 항상 유지된다.
재시작에도 살아남게 하려면 저장소를 교체한다. 예를 들어 JDBC 저장소는 전용 스타터를 추가한 뒤 그대로 꽂으면 된다.
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-starter-model-chat-memory-repository-jdbc</artifactId>
</dependency>// jdbcTemplate은 JDBC 스타터가 자동 구성한 빈을 생성자/필드로 주입받아 쓴다
ChatMemoryRepository repository = JdbcChatMemoryRepository.builder()
.jdbcTemplate(jdbcTemplate)
.dialect(new PostgresChatMemoryRepositoryDialect())
.build();
ChatMemory chatMemory = MessageWindowChatMemory.builder()
.chatMemoryRepository(repository) // 인메모리 대신 JDBC로 교체
.maxMessages(20)
.build();chatMemoryRepository(...)에 JDBC 구현을 넣으면 같은 윈도우 로직은 그대로 두고 저장 위치만 DB로 바뀐다. PostgreSQL·MySQL·Oracle 등을 지원하며, spring.ai.chat.memory.repository.jdbc.initialize-schema=embedded 설정으로 스키마를 자동 생성할 수 있다. Redis·MongoDB·Cassandra·Neo4j 저장소도 각자 스타터로 제공된다. 다만 한 가지 함정이 있다. JDBC·Cassandra·MongoDB 저장소는 tool call 메시지(툴 호출·응답)를 저장하지 않고 걸러 낸다(ChatMemory 공식 문서). 툴 호출 이력까지 보존해야 한다면 Spring AI Session(JDBC session store)을 따로 고려해야 한다.
진짜 장기 기억 — AutoMemoryTools로 사실을 파일에 적어 두기
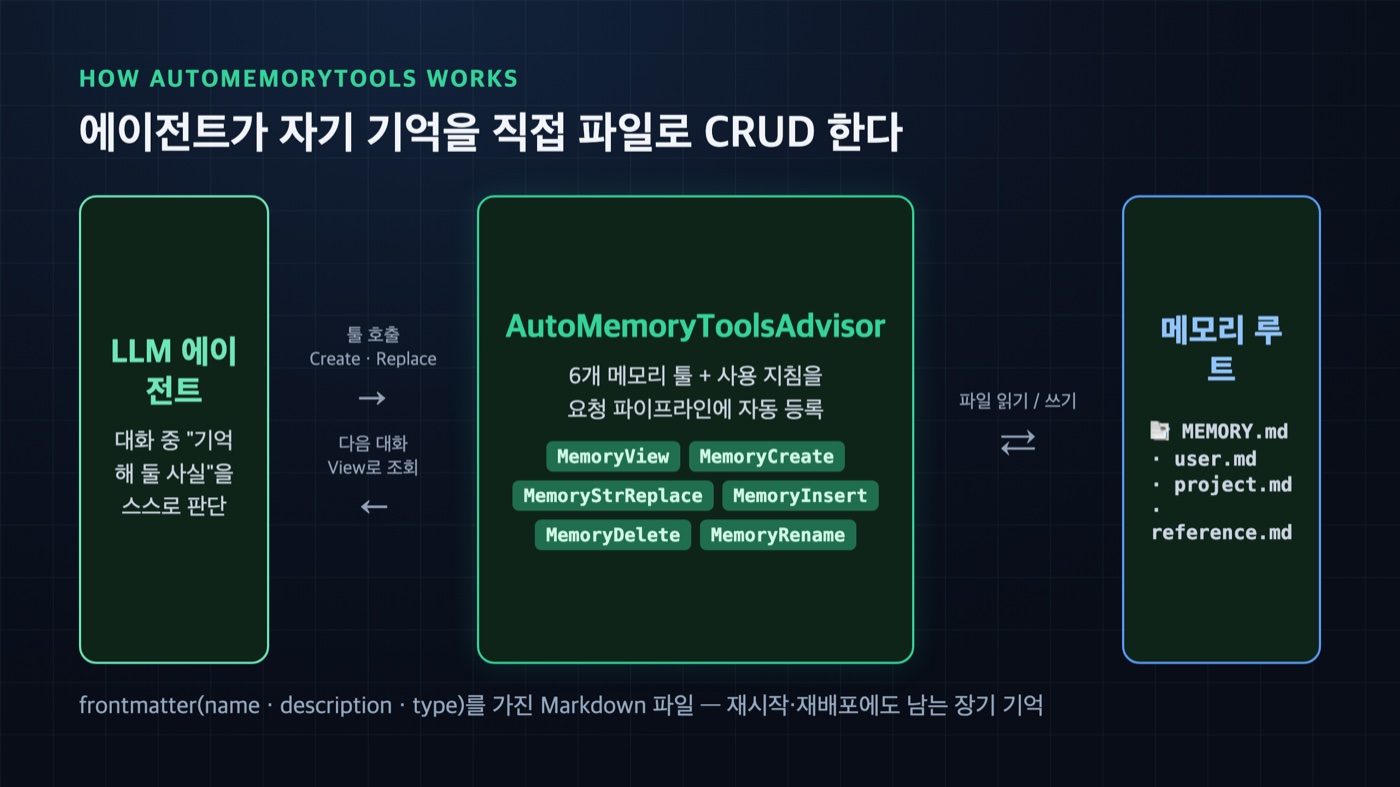
Spring AI 메모리에서 진짜 장기 기억은 대화 윈도우가 아니라, 사용자의 사실·선호를 에이전트가 직접 파일에 적어 두고 꺼내 쓰는 방식이다. Spring AI 커뮤니티 라이브러리 spring-ai-agent-utils의 AutoMemoryTools가 이 역할을 한다. 설정한 루트 디렉터리 아래에 Markdown 메모리 파일을 만들고, 읽고, 고치고, 지우는 여섯 개의 툴을 LLM에게 쥐어 주는 구조다. 윈도우가 넘쳐도 사라지지 않고, 재시작해도 남는다.
구조를 보면 Claude Code 같은 AI 코딩 에이전트의 메모리와 사실상 똑같다. 루트에 인덱스 파일 MEMORY.md가 있고, 그 아래 토픽별 Markdown 파일이 쌓인다. 각 파일은 frontmatter에 name·description·type을 담는다.
---
name: user profile
description: Priya는 간결한 답변을 선호하는 백엔드 개발자다.
type: user
---
Priya는 주로 Java와 Spring Boot로 일한다. 장황한 설명보다 코드 예제를 먼저 본다.이 파일은 사람이 쓰는 게 아니라 LLM이 대화 중 알게 된 사실을 스스로 적어 넣은 결과다. description은 나중에 어떤 메모리를 꺼낼지 판단하는 요약으로 쓰이고, type(user·project·reference 등)으로 성격을 구분한다. 에이전트는 다음 대화에서 MEMORY.md 인덱스를 훑어 관련 파일만 읽어 들인다.
AutoMemoryTools가 제공하는 여섯 툴은 역할이 뚜렷하다.
| 툴 | 하는 일 |
|---|---|
MemoryView | 메모리 파일 목록을 보거나 한 파일을 줄 번호와 함께 읽는다 |
MemoryCreate | 새 메모리 파일을 만든다 |
MemoryStrReplace | 기존 파일에서 정확히 일치하는 한 구간만 교체한다 |
MemoryInsert | 특정 줄 뒤에 내용을 삽입한다(주로 인덱스 항목 추가) |
MemoryDelete | 루트 아래 메모리 파일·디렉터리를 지운다 |
MemoryRename | 메모리 파일을 이름 변경하거나 이동한다 |
LLM은 대화 흐름에서 “이건 기억해 둘 만하다” 싶을 때 MemoryCreate로 파일을 만들고, 사실이 바뀌면 MemoryStrReplace로 해당 줄만 고친다. 사람이 메모를 관리하듯 에이전트가 자기 메모리를 직접 CRUD 하는 셈이다. 이 여섯 툴과 사용 지침(system prompt)을 요청 파이프라인에 자동으로 끼워 넣는 게 AutoMemoryToolsAdvisor다.
의존성은 BOM으로 버전을 관리한다. Spring AI BOM이 관리하지 않는 별도 커뮤니티 라이브러리라 버전을 명시한다.
<dependencyManagement>
    <dependencies>
        <dependency>
            <groupId>org.springframework.ai</groupId>
            <artifactId>spring-ai-bom</artifactId>
            <version>2.0.1</version>
            <type>pom</type>
            <scope>import</scope>
        </dependency>
        <dependency>
            <groupId>org.springaicommunity</groupId>
            <artifactId>spring-ai-agent-utils-bom</artifactId>
            <version>0.12.0</version>
            <type>pom</type>
            <scope>import</scope>
        </dependency>
    </dependencies>
</dependencyManagement>

<dependencies>
    <dependency>
        <groupId>org.springframework.ai</groupId>
        <artifactId>spring-ai-starter-model-openai</artifactId>
    </dependency>
    <dependency>
        <groupId>org.springaicommunity</groupId>
        <artifactId>spring-ai-agent-utils</artifactId>
    </dependency>
    <dependency>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-web</artifactId>
    </dependency>
</dependencies>Spring AI BOM(2.0.1)과 agent-utils BOM(0.12.0)을 각각 import 하고, OpenAI 모델 스타터와 agent-utils, 웹 스타터를 의존성으로 선언한다. agent-utils는 Spring AI BOM이 버전을 관리하지 않으므로 자체 BOM으로 버전을 고정하는 점이 중요하다(spring-ai-agent-utils). 설정 파일에는 API 키와 메모리 루트 디렉터리를 지정한다.
spring.ai.openai.api-key=${OPENAI_API_KEY}
agent.memory.dir=${user.home}/.demo-agent/memoryagent.memory.dir가 메모리 파일이 쌓일 루트다. 홈 디렉터리 아래에 두면 애플리케이션을 재시작해도, 심지어 다시 배포해도 그 파일들이 남아 장기 기억이 된다. 이 디렉터리 경로를 AutoMemoryToolsAdvisor에 넘기는 것이 다음 절의 와이어링이다.
단기와 장기를 함께 — ChatClient에 두 기억을 모두 물리기
실무에서 Spring AI 메모리는 단기와 장기 기억을 함께 쓴다. ChatClient의 defaultAdvisors에 AutoMemoryToolsAdvisor(장기)와 MessageChatMemoryAdvisor(단기)를 같이 등록하면, 에이전트는 최근 대화 맥락을 유지하면서 중요한 사실은 파일로 남긴다. 둘은 역할이 겹치지 않으므로 함께 써야 완성된다.
import org.springaicommunity.agent.advisors.AutoMemoryToolsAdvisor;
import org.springframework.ai.chat.client.ChatClient;
import org.springframework.ai.chat.client.advisor.MessageChatMemoryAdvisor;
import org.springframework.ai.chat.memory.MessageWindowChatMemory;
import org.springframework.ai.chat.model.ChatModel;
import org.springframework.beans.factory.annotation.Value;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

@Configuration
public class AgentConfig {

    @Bean
    public ChatClient chatClient(ChatModel chatModel,
                                 @Value("${agent.memory.dir}") String memoryDir) {
        return ChatClient.builder(chatModel)
                .defaultSystem("너는 사용자의 선호와 사실을 기억하는 백엔드 도우미다.")
                .defaultAdvisors(
                        // 장기 기억: 파일로 사실을 남기고 꺼낸다
                        AutoMemoryToolsAdvisor.builder()
                                .memoriesRootDirectory(memoryDir)
                                .build(),
                        // 단기 기억: 최근 20개 대화 맥락을 유지한다
                        MessageChatMemoryAdvisor.builder(
                                MessageWindowChatMemory.builder()
                                        .maxMessages(20)
                                        .build()
                        ).build()
                )
                .build();
    }
}AutoMemoryToolsAdvisor.builder().memoriesRootDirectory(memoryDir).build()가 앞서 설정한 루트 디렉터리를 장기 기억 저장소로 지정하는 부분이다. 이 advisor가 시스템 프롬프트에 “필요하면 메모리 툴을 써서 사실을 저장·조회하라”는 지침과 여섯 툴을 함께 등록한다. 그 아래 MessageChatMemoryAdvisor가 단기 대화 맥락을 책임진다. 두 advisor를 나란히 두면, LLM은 “방금 한 말”은 윈도우에서, “지난주에 말한 선호”는 파일에서 각각 꺼내 온다.
호출부는 앞서 본 /chat 컨트롤러 그대로다. 사용자가 “나는 긴 설명보다 코드를 먼저 보는 걸 선호해”라고 말하면, 에이전트가 MemoryCreate로 user 타입 메모리를 남긴다. 며칠 뒤 새 세션에서 질문해도 그 선호가 반영된 답이 돌아온다. 단기 기억만으로는 윈도우가 밀려나면 잊히지만, 장기 기억은 파일에 남아 세션을 넘어 유지되기 때문이다.
의미로 기억을 찾고 싶다면 — VectorStore 기반 장기 기억
파일 기반 AutoMemoryTools가 “에이전트가 직접 관리하는 메모”라면, VectorStore 기반 장기 기억은 “의미로 검색하는 메모”다. VectorStoreChatMemoryAdvisor는 과거 대화를 임베딩해 벡터 저장소에 넣어 두고, 현재 질문과 의미가 가까운 기억을 꺼내 시스템 메시지에 붙인다. 정확한 파일 구조 없이 “비슷한 맥락”을 찾고 싶을 때 유용하다.
import org.springframework.ai.chat.client.advisor.vectorstore.VectorStoreChatMemoryAdvisor;
import org.springframework.ai.chat.prompt.PromptTemplate;

// 장기 기억을 시스템 메시지에 어떻게 합칠지 템플릿으로 정의한다
PromptTemplate template = new PromptTemplate(
        "System: {instructions}\n\nMemory: {long_term_memory}");

// builder()는 VectorStore를 인자로 받고, 템플릿은 systemPromptTemplate(...)로 넘긴다
VectorStoreChatMemoryAdvisor advisor = VectorStoreChatMemoryAdvisor.builder(vectorStore)
        .systemPromptTemplate(template)
.build();VectorStoreChatMemoryAdvisor는 벡터 저장소에서 꺼낸 기억을 {long_term_memory} 자리에, 원래 시스템 메시지를 {instructions} 자리에 끼워 하나의 시스템 프롬프트로 합친다. 이 두 placeholder는 템플릿에 반드시 있어야 한다(ChatMemory 공식 문서). AutoMemoryTools와는 결이 다르다. AutoMemoryTools는 사람이 읽을 수 있는 파일에 사실을 또렷하게 적어 두는 쪽이고, VectorStore는 대화를 통째로 임베딩해 의미가 가까운 걸 끌어온다. “이 사용자는 Java 개발자”처럼 딱 떨어지는 사실이면 파일 쪽이, “예전에 비슷한 걸 물어봤던 것 같은데” 하는 흐릿한 맥락이면 벡터 쪽이 낫다.
프로덕션에서 흔히 밟는 지점 — 스케일아웃·토큰·민감정보
Spring AI 메모리를 운영에 올리면 구현보다 운영에서 더 자주 막힌다. 특히 세 가지를 미리 잡아 두는 게 좋다. 인메모리 저장소의 멀티 인스턴스 문제, 기억이 늘수록 커지는 토큰 비용, 그리고 장기 기억에 남는 민감정보다. 셋 다 기능이 아니라 정책의 문제라, 코드를 짜기 전에 결정해 두는 편이 낫다.
가장 먼저 부딪히는 건 스케일아웃이다. 기본 InMemoryChatMemoryRepository는 JVM 프로세스마다 별도라, 로드밸런서 뒤에 인스턴스가 둘 이상이면 같은 사용자의 요청이 다른 인스턴스로 흩어지면서 대화가 끊기거나 섞인다. 인스턴스가 하나일 때만 안전하고, 둘 이상이라면 앞서 본 JDBC·Redis 같은 공유 저장소로 바꿔야 대화 맥락이 인스턴스를 넘어 유지된다. 재시작뿐 아니라 수평 확장도 저장소 선택을 강제하는 지점이다.
다음은 토큰과 비용이다. 단기 기억 윈도우가 클수록, 장기 기억에서 끌어오는 사실이 많을수록 매 요청 프롬프트가 길어지고 그만큼 토큰 과금이 늘어난다. maxMessages를 무작정 키우기보다, 정말 필요한 맥락만 유지하고 “무엇을 장기 기억으로 남길지”를 system prompt로 좁히는 편이 비용 대비 효과가 좋다. AutoMemoryTools처럼 LLM이 저장을 판단하는 구조에서는 “사소한 건 저장하지 말라”는 지침 한 줄이 메모리 파일이 무한정 불어나는 걸 막아 준다.
마지막은 민감정보다. 사용자가 대화 중 흘린 개인정보가 장기 기억 파일이나 벡터 저장소에 영구로 남을 수 있다. AutoMemoryTools는 설정한 루트 디렉터리 밖은 건드리지 못하도록 범위가 제한돼 있지만, 루트 안에 무엇이 쌓이는지는 애플리케이션의 책임이다. 저장 전에 마스킹하거나, type으로 성격을 구분해 보관·삭제 정책을 다르게 두는 식으로 통제해야 한다. 기억은 켜는 것보다 지우는 쪽을 설계하는 게 더 어렵다.
Spring AI 메모리 전략 비교 — 언제 무엇을 쓰나
Spring AI 메모리는 하나를 고르는 게 아니라 목적에 따라 조합한다. 단기 맥락은 ChatMemory, 명시적 사실은 AutoMemoryTools, 의미 검색은 VectorStore가 맡는다. 어떤 상황에 무엇이 맞는지 표로 보면 이렇다.
| 전략 | 저장 위치 | 수명 | 적합한 용도 | 한계 |
|---|---|---|---|---|
| ChatMemory (인메모리) | JVM 메모리 | 재시작 시 소멸 | 현재 대화 맥락 유지 | 재시작·스케일아웃에 취약 |
| ChatMemory (JDBC·Redis) | DB·Redis | 영속 | 재시작 넘는 대화 이력 | tool call 메시지 미저장 |
| AutoMemoryTools (파일) | Markdown 파일 | 영속 | 명시적 사실·선호 저장 | LLM이 저장을 판단(누락 가능), 파일 I/O |
| VectorStore | 벡터 DB | 영속 | 의미 기반 기억 검색 | 임베딩 비용, 정확한 사실엔 부정확 |
표에서 보듯 ChatMemory와 장기 기억은 대체재가 아니라 층이다. 단기 기억만 쓰면 윈도우가 밀려날 때 다 잊고, 장기 기억만 쓰면 바로 직전 문맥이 끊긴다. 그래서 앞 절처럼 MessageChatMemoryAdvisor와 AutoMemoryToolsAdvisor를 함께 묶는 구성이 가장 흔하다. 몇 가지 공통 함정도 기억해 둘 만하다. conversationId를 사용자별로 안 나누면 대화가 섞이고, tool call 이력은 기본 저장소에 안 남으며, 장기 기억은 토큰과 비용을 먹으므로 “무엇을 기억할지”를 system prompt로 좁혀 두는 편이 낫다. Spring AI의 기본 개념이 낯설다면 Spring AI 2.0 시작하기 글에서 ChatClient와 advisor 구조를 먼저 짚고 오면 이 구성이 훨씬 또렷하게 보인다.
FAQ
ChatMemory와 AutoMemoryTools는 뭐가 다른가?
Spring AI 메모리에서 ChatMemory는 최근 대화 메시지를 윈도우로 유지하는 단기 기억이고, AutoMemoryTools는 사용자의 사실·선호를 Markdown 파일에 영구 저장하는 장기 기억이다. ChatMemory는 윈도우가 넘치거나 재시작하면 사라지지만, AutoMemoryTools는 파일에 남아 세션을 넘어 유지된다. 실무에서는 둘을 함께 쓴다.
conversationId를 안 넘기면 어떻게 되나?
Spring AI가 런타임에 IllegalArgumentException을 던진다. conversationId는 메모리 연산을 특정 대화에 묶는 필수 값이라, 누락하면 요청이 실패한다. 사용자 ID와 세션 ID를 조합해 서버에서 파생하고, 클라이언트가 보낸 값을 그대로 신뢰하지 않는 것이 안전하다.
대화가 길어지면 오래된 메시지는 어떻게 되나?
MessageWindowChatMemory가 기본 20개 상한을 넘기면 오래된 메시지부터 버린다. 단 대화 턴 경계를 지켜 자르므로 질문만 남고 답이 잘려 나가지는 않으며, SystemMessage는 항상 유지된다. 더 긴 맥락이 필요하면 maxMessages를 늘리거나 장기 기억을 병행한다.
재시작해도 기억을 유지하려면?
ChatMemory의 저장소를 인메모리에서 JDBC·Redis·MongoDB 등 영속 저장소로 바꾸면 된다. 전용 스타터(예: spring-ai-starter-model-chat-memory-repository-jdbc)를 추가하고 chatMemoryRepository(...)에 넣으면 윈도우 로직은 그대로 두고 저장 위치만 바뀐다. 사실 단위 장기 기억이 목적이라면 AutoMemoryTools나 VectorStore가 더 맞다.
AutoMemoryTools는 Spring AI 기본 기능인가?
아니다. org.springaicommunity:spring-ai-agent-utils라는 커뮤니티 라이브러리로 제공되며, Spring AI BOM이 버전을 관리하지 않으므로 자체 BOM(0.12.0)으로 버전을 고정해야 한다. AutoMemoryToolsAdvisor를 통해 여섯 개의 메모리 툴과 사용 지침이 ChatClient 파이프라인에 자동 등록된다.
마치며
AI 챗봇을 처음 붙일 때 가장 당황스러운 순간은, 바로 윗줄에서 사용자가 자기 이름을 말했는데 다음 답에서 “성함이 어떻게 되시죠?”라고 되묻는 장면이었다. LLM이 stateless라는 걸 머리로는 알아도, 막상 대화가 끊기는 걸 보면 “기억”이라는 게 공짜가 아니라는 걸 실감한다. ChatMemory 하나만 붙여도 그 즉시 대화가 이어지는 경험은 꽤 극적이다.
그런데 운영에 올리면 진짜 어려운 건 “무엇을 얼마나 오래 기억할 것인가”다. 전부 기억하면 토큰 비용이 눈덩이처럼 불고, 적게 기억하면 맥락이 끊긴다. AutoMemoryTools의 파일 기반 접근이 반가웠던 건, 에이전트가 기억한 내용을 사람이 열어서 직접 읽고 고칠 수 있다는 점이었다. 벡터로 뭉뚱그린 기억은 디버깅이 막막한데, Markdown 파일은 “얘가 나를 이렇게 알고 있구나”가 한눈에 보인다. 공교롭게도 이 구조는 내가 매일 쓰는 AI 코딩 에이전트의 메모리와 판박이였고, 결국 좋은 기억 설계는 도구를 가리지 않는다는 생각이 들었다. 지금까지 Spring AI 메모리를 단기 기억부터 장기 기억까지 정리해 보았다.