밤 2시에 도는 정산 배치가 3시간째 끝나지 않고, 아침 출근길에 “아직도 돌아요?” 슬랙이 오는 경험은 배치를 다뤄 본 사람이라면 한 번쯤 겪는다. 원인의 상당수는 로직이 아니라 구조다. 1,000만 건을 ItemReader 하나가 한 줄씩 읽어 순차로 처리하면 CPU 코어가 여러 개여도 한 코어만 일한다. Spring Batch 파티셔닝은 이 잡을 ID 구간 같은 조각으로 쪼개 여러 스레드가 동시에 자기 몫만 처리하게 만든다. 이 글에서는 스케일링 선택지를 먼저 비교하고, 파티셔닝이 데이터를 어떻게 나누는지, 매니저와 워커 스텝을 어떻게 설정하는지, 그리고 gridSize를 무작정 올리면 왜 다시 느려지는지와 파티션이 영원히 멈추는 함정까지 코드와 실측 수치로 짚는다.
Spring Batch에서 배치를 빠르게 만드는 5가지 방법
Spring Batch는 스케일링 수단을 다섯 가지 제공하고, 상황에 따라 고르는 게 핵심이다. 단일 스텝을 여러 스레드로 돌리는 멀티스레드 스텝, 서로 독립적인 스텝을 병렬로 실행하는 병렬 스텝, 하나의 스텝을 데이터 구간별로 복제해 돌리는 파티셔닝, 그리고 처리·읽기를 다른 JVM으로 넘기는 원격 파티셔닝·원격 청킹이다. 대용량 단일 테이블 처리에는 대개 파티셔닝이 가장 잘 맞는다.
| 방식 | 무엇을 나누나 | 적합한 상황 | 주의 |
|---|---|---|---|
| 단일 청크(기본) | 나누지 않음 | 데이터가 작을 때 | 코어 하나만 사용 |
| 멀티스레드 스텝 | 한 스텝의 청크들 | 간단히 병렬화 | Reader가 스레드 세이프해야 함 |
| 병렬 스텝(Split) | 독립적인 스텝들 | 서로 무관한 작업 동시 실행 | 스텝 간 의존 없을 때만 |
| 파티셔닝(로컬) | 데이터 구간(파티션) | 대용량 단일 테이블/파일 | gridSize·스레드 풀 튜닝 필요 |
| 원격 파티셔닝 | 데이터 구간 + 처리 노드 | 한 JVM으로 부족할 때 | 메시징 미들웨어 필요 |
표에서 멀티스레드 스텝과 파티셔닝은 헷갈리기 쉬운데, 결정적 차이는 상태 격리다. 멀티스레드 스텝은 하나의 ItemReader 인스턴스를 여러 스레드가 공유하므로 Reader가 스레드 세이프해야 하고 재시작 시 상태 관리가 까다롭다. 반면 파티셔닝은 각 파티션이 자기만의 스텝 실행 컨텍스트와 Reader를 갖는다. 그래서 “3번 파티션만 실패했으니 3번만 다시” 같은 재시작이 자연스럽게 된다. 공식 문서의 Scaling and Parallel Processing 장에 다섯 방식이 정리돼 있다.
Spring Batch 파티셔닝은 데이터를 어떻게 나누나
파티셔닝의 핵심은 Partitioner가 데이터를 직접 건드리지 않는다는 데 있다. Partitioner는 “각 파티션이 어떤 범위를 맡을지”를 설명하는 메타데이터(ExecutionContext)만 만들어 낸다. 실제 읽기는 각 워커 스텝이 그 메타데이터를 받아 수행한다. 예를 들어 ID가 1부터 1,000만까지라면, Partitioner는 “0번은 1–250만, 1번은 250만–500만…” 같은 구간 정보만 담은 ExecutionContext를 파티션 수만큼 반환한다.
public class ColumnRangePartitioner implements Partitioner {

    private final long min;
    private final long max;

    public ColumnRangePartitioner(long min, long max) {
        this.min = min;
        this.max = max;
    }

    @Override
    public Map<String, ExecutionContext> partition(int gridSize) {
        long targetSize = (max - min) / gridSize + 1;
        Map<String, ExecutionContext> result = new HashMap<>();

        long start = min;
        long end = start + targetSize - 1;
        for (int i = 0; i < gridSize; i++) {
            ExecutionContext ctx = new ExecutionContext();
            if (end >= max) end = max;
            ctx.putLong("minValue", start);   // 이 파티션이 맡을 시작 ID
            ctx.putLong("maxValue", end);     // 끝 ID
            result.put("partition" + i, ctx);
            start += targetSize;
            end += targetSize;
        }
        return result;
    }
}위 코드에서 partition(int gridSize)가 하는 일은 ID 범위를 gridSize개로 균등 분할해 각 구간의 minValue·maxValue를 ExecutionContext에 담는 것뿐이다. 반환한 Map의 키(partition0, partition1…)는 각 파티션 스텝 실행의 이름이 된다. 데이터는 한 줄도 읽지 않고 “누가 어디를 맡는다”는 지도만 그린다. 실제 SELECT는 다음 단계인 워커 스텝이 맡는다.
한 가지 미리 알아둘 함정이 있다. gridSize가 항상 파티션 개수를 결정하지는 않는다. 위 ColumnRangePartitioner는 gridSize대로 나누지만, 파일 단위로 나누는 MultiResourcePartitioner는 gridSize 인자를 무시하고 발견된 파일 수만큼 파티션을 만든다. 내가 쓰는 Partitioner 구현이 gridSize를 실제로 반영하는지부터 확인해야 한다.
매니저 스텝과 워커 스텝은 어떻게 연결되나
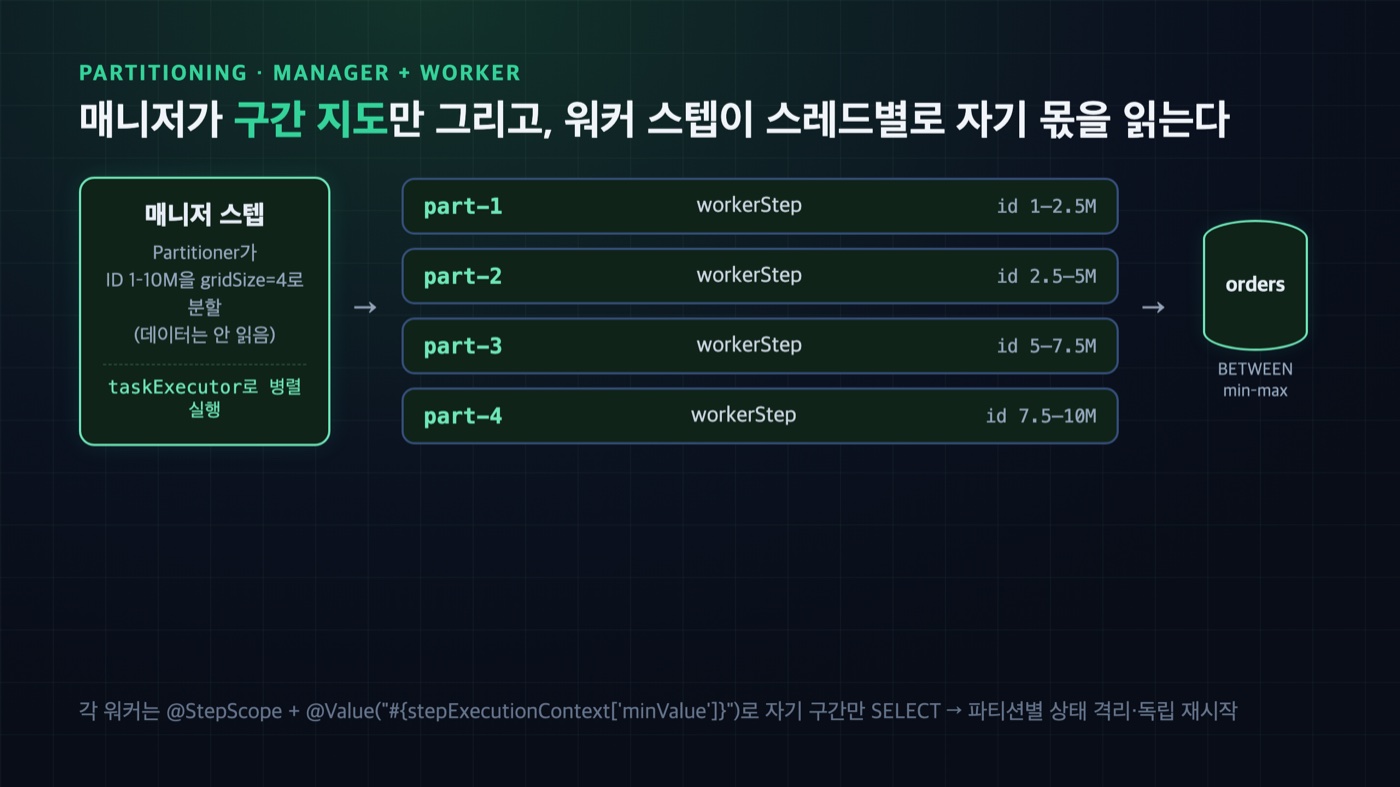
파티셔닝은 매니저 스텝 하나와 워커 스텝 하나로 구성되고, 이 둘을 하나의 Job으로 묶는다. 매니저 스텝은 Partitioner로 파티션 지도를 만들고 TaskExecutor로 각 파티션을 워커 스텝 인스턴스에 태워 병렬 실행시키는 조율자다. 워커 스텝은 평범한 청크 지향 스텝인데, 자기 파티션의 범위를 @StepScope와 @Value("#{stepExecutionContext['...']}") 지연 바인딩으로 주입받는다는 점만 다르다.
@Configuration
public class PartitionJobConfig {

    // 잡: 매니저 스텝으로 시작한다. 스케줄러가 주입받는 게 바로 이 Job 빈이다.
    @Bean
    public Job partitionJob(JobRepository jobRepository, Step managerStep) {
        return new JobBuilder("partitionJob", jobRepository)
                .start(managerStep)
                .build();
    }

    // 매니저 스텝: Partitioner + gridSize + TaskExecutor
    @Bean
    public Step managerStep(JobRepository jobRepository, Step workerStep,
                            TaskExecutor partitionTaskExecutor) {
        return new StepBuilder("managerStep", jobRepository)
                .partitioner("workerStep", new ColumnRangePartitioner(1, 10_000_000))
                .step(workerStep)
                .gridSize(4)
                .taskExecutor(partitionTaskExecutor)
                .build();
    }

    // 워커 스텝: 평범한 청크 스텝
    @Bean
    public Step workerStep(JobRepository jobRepository, PlatformTransactionManager tx,
                           ItemReader<Order> workerReader,
                           ItemWriter<Order> writer) {
        return new StepBuilder("workerStep", jobRepository)
                .<Order, Order>chunk(1000, tx)
                .reader(workerReader)
                .writer(writer)
                .build();
    }

    // 워커 Reader: 자기 파티션의 minValue~maxValue만 읽는다
    @Bean
    @StepScope
    public JdbcCursorItemReader<Order> workerReader(
            DataSource dataSource,
            @Value("#{stepExecutionContext['minValue']}") Long min,
            @Value("#{stepExecutionContext['maxValue']}") Long max) {
        return new JdbcCursorItemReaderBuilder<Order>()
                .name("workerReader")
                .dataSource(dataSource)
                .sql("SELECT id, amount FROM orders WHERE id BETWEEN ? AND ?")
                .preparedStatementSetter(
                        new ArgumentPreparedStatementSetter(new Object[]{min, max}))
                .rowMapper((rs, n) -> new Order(rs.getLong("id"), rs.getBigDecimal("amount")))
                .build();
    }
}이 구성의 핵심은 세 곳이다. 첫째, managerStep의 .partitioner("workerStep", partitioner)는 “workerStep이라는 워커를 이 Partitioner가 나눈 대로 복제하라”는 선언이다. 둘째, .taskExecutor(...)가 있어야 파티션들이 병렬로 돈다. 이걸 빼면 파티션은 만들어지되 한 스레드에서 순차 실행돼 빨라지지 않는다. 셋째, workerReader의 @StepScope와 @Value가 지연 바인딩의 핵심이다. 스프링 컨텍스트 기동 시점에는 minValue가 없고, 각 파티션 스텝이 시작될 때 비로소 그 파티션의 값이 주입된다. @StepScope가 없으면 이 바인딩이 동작하지 않는다.
참고로 Spring Batch 5.0부터 JobBuilderFactory와 StepBuilderFactory가 제거됐다. 위 코드처럼 new StepBuilder("name", jobRepository) 생성자에 JobRepository를 직접 넘기는 방식이 현재 표준이다. 예전 블로그 예제를 그대로 복사하면 컴파일이 안 되는 경우가 많으니 버전을 확인해야 한다. 마이그레이션 내역은 Spring Batch 5.0 Migration Guide에 정리돼 있다.
한 가지 더 짚어둘 점은 위 코드가 파라미터로 받는 JobRepository·PlatformTransactionManager·DataSource를 내가 만들지 않았다는 것이다. spring-boot-starter-batch가 클래스패스에 있고 DataSource가 있으면, Spring Boot의 배치 auto-configuration이 JobRepository·JobLauncher·JobExplorer 같은 인프라 빈을 자동 등록한다. 그래서 이들은 정의 없이 주입만 받으면 되고, 내가 실제로 @Bean으로 만들어야 하는 건 Job·Step·ItemReader/ItemWriter·Partitioner·TaskExecutor 같은 배치 로직 빈뿐이다. 뒤에서 스케줄러가 주입받는 JobLauncher도 이렇게 자동 구성된 빈이고, partitionJob은 내가 만든 Job 빈이 이름으로 주입되는 것이다. 참고로 Boot 3에서는 @EnableBatchProcessing을 붙이지 않는 편이 낫다. 붙이면 오히려 이 auto-configuration이 물러나 인프라 빈을 직접 구성해야 한다.
gridSize를 늘리면 무조건 빨라질까?
아니다. gridSize는 코어 수 근처에서 최적이고, 그걸 넘어가면 오히려 느려진다. 파티션이 코어보다 많아지면 컨텍스트 스위칭과 DB 커넥션 경합이 이득을 갉아먹기 때문이다. 한 공개 벤치마크(2-vCPU 환경, 1,000만 행)의 실측치가 이 경향을 잘 보여 준다. gridSize를 코어 수와 같은 2로 뒀을 때 가장 빨랐고, 4로 늘리자 다시 느려졌다.
| gridSize | 처리 시간 | 초당 행 | 속도 향상 |
|---|---|---|---|
| 1 | 70.5s | 141,874 | 1.00x |
| 2 | 49.6s | 201,422 | 1.42x |
| 4 | 53.1s | 188,317 | 1.33x |
수치의 출처는 10M 행 잡을 파티셔닝으로 스케일링한 사례이며, 2코어 환경이라 gridSize 2에서 정점을 찍고 4에서 꺾였다. “파티션을 많이 쪼갤수록 빨라진다”는 직관은 여기서 깨진다. 파티셔닝의 병목은 대개 CPU가 아니라 DB다. 워커가 늘면 동시에 열리는 DB 커넥션도 늘어나므로, 커넥션 풀 크기와 gridSize를 함께 봐야 한다. gridSize를 8로 잡아도 커넥션 풀이 4면 절반은 커넥션을 기다리며 논다. 실무에서는 코어 수, DB 커넥션 풀, 대상 DB의 동시 쿼리 처리 능력 중 가장 낮은 값에 gridSize를 맞추는 편이 안전하다.
흔한 함정 — 스레드 풀이 작으면 파티션이 영원히 멈춘다
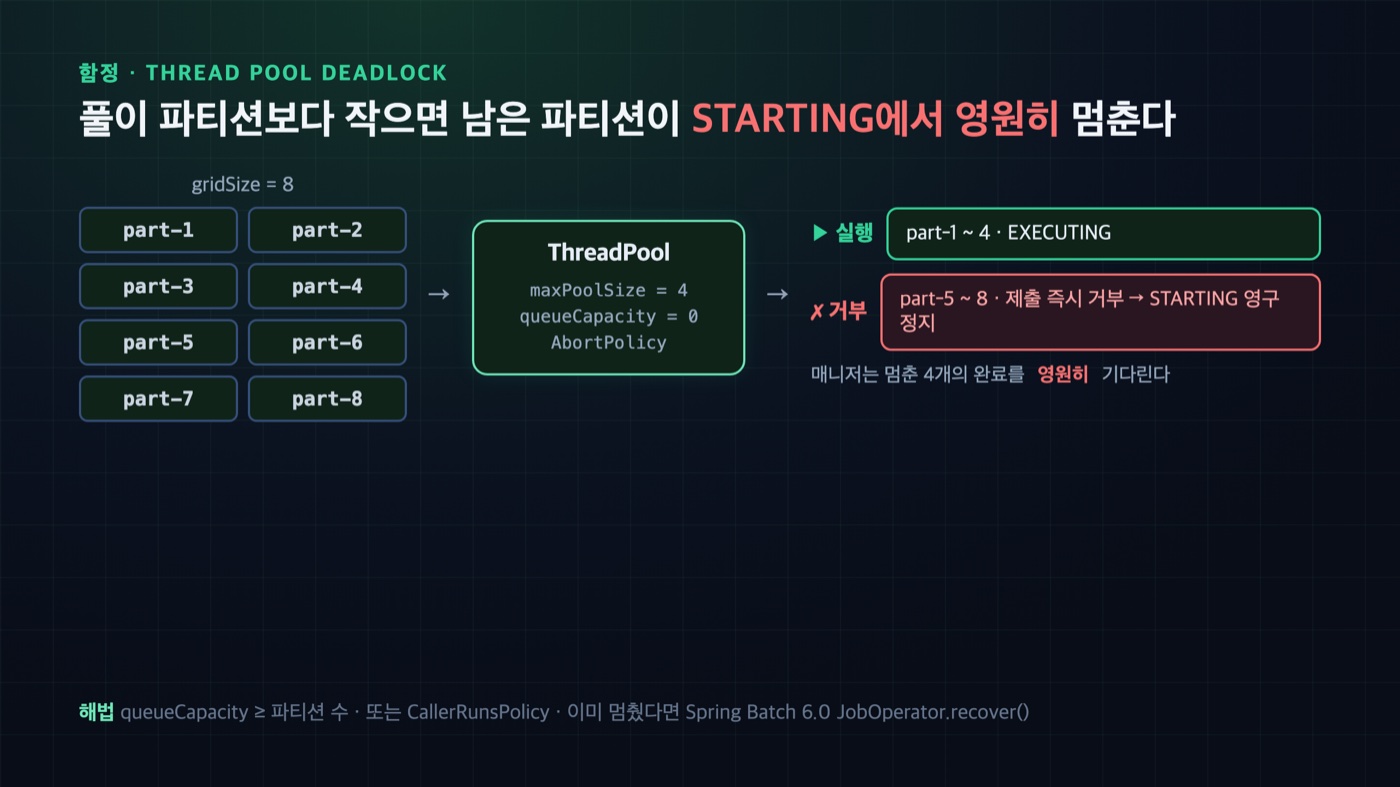
파티셔닝에서 가장 당황스러운 장애는 잡이 실패하지도 끝나지도 않고 STARTING 상태로 영원히 멈추는 것이다. 원인은 대개 TaskExecutor의 스레드 풀이 파티션 수보다 작은데 큐 용량이 0이고 거부 정책이 AbortPolicy인 조합이다. 제출된 파티션이 풀에 자리가 없어 거부되면, 매니저는 그 파티션의 완료를 영원히 기다린다.
@Bean
public TaskExecutor partitionTaskExecutor() {
    ThreadPoolTaskExecutor executor = new ThreadPoolTaskExecutor();
    executor.setCorePoolSize(4);
    executor.setMaxPoolSize(4);
    executor.setQueueCapacity(16);   // 0으로 두면 자리 없을 때 파티션이 거부된다
    executor.setThreadNamePrefix("part-");
    executor.initialize();
    return executor;
}위 설정에서 위험한 조합은 queueCapacity(0) + 작은 maxPoolSize + AbortPolicy다. gridSize가 8인데 풀이 4이고 큐가 0이면, 5번째 파티션부터 제출과 동시에 거부되고 그 스텝은 STARTING에서 멈춘 채로 남는다. 큐 용량을 파티션 수 이상으로 잡거나, 최소한 거부 정책을 CallerRunsPolicy로 두면 자리가 없을 때 호출 스레드가 직접 실행해 교착을 피한다. gridSize 하나만 보지 말고 풀 크기와 큐 용량을 같은 세트로 설계해야 한다.
이미 멈춘 잡을 복구하는 수단도 있다. Spring Batch 6.0의 JobOperator.recover(JobExecution)는 STARTING이나 STARTED에 고아로 남은 스텝 실행을 강제로 FAILED로 닫아 준다. 그 뒤 재시작하면 완료된 파티션은 건너뛰고 실패한 파티션만 다시 돈다. 파티션별로 상태가 격리돼 있어 가능한 복구다. 다만 근본 해법은 애초에 풀·큐·gridSize를 맞춰 교착이 안 나게 하는 것이다.
로컬 파티셔닝 vs 원격 파티셔닝 — 언제 무엇을 쓰나
지금까지 다룬 것은 한 JVM 안에서 스레드로 병렬화하는 로컬 파티셔닝이다. 처리량이 한 서버의 CPU·메모리 한계에 부딪히면 원격 파티셔닝으로 넘어간다. 매니저는 파티션 메타데이터를 Kafka나 RabbitMQ 같은 메시징 미들웨어로 워커 노드들에 뿌리고, 실제 처리는 여러 대의 워커 JVM이 나눠 맡는다. 파티션을 나누는 원리는 같고, 워커가 스레드냐 별도 프로세스냐가 다르다.
| 구분 | 로컬 파티셔닝 | 원격 파티셔닝 |
|---|---|---|
| 워커 위치 | 같은 JVM의 스레드 | 여러 JVM/서버 |
| 병렬 한계 | 한 서버의 코어 수 | 워커 노드 수만큼 |
| 필요 인프라 | 없음(TaskExecutor) | 메시징 미들웨어(Kafka 등) |
| 복잡도 | 낮음 | 높음(직렬화·네트워크·모니터링) |
| 적합 규모 | 수백만~수천만 행 | 수억 행, 단일 서버 초과 |
대부분의 배치는 로컬 파티셔닝으로 충분하다. 1,000만 행짜리 잡이 한 서버에서 코어를 다 쓰지도 못하고 있는데 원격부터 도입하면, 얻는 것 없이 메시징 직렬화·네트워크 지연·워커 모니터링이라는 운영 비용만 늘어난다. 원격은 “한 서버로는 도저히 안 된다”가 데이터로 확인됐을 때 꺼내는 카드다. 배치를 언제 돌릴지, 중복 실행을 어떻게 막을지는 이 블로그의 Spring Boot 동적 Cron 스케줄링과 ShedLock으로 스케줄러 중복 실행 막기에서 다뤘으니, “언제·중복 없이·빠르게”의 마지막 조각으로 이 글을 보면 된다.
직접 돌려서 파티션이 병렬로 도는지 확인하기
정말 파티션이 서로 다른 스레드에서 동시에 도는지는 로그 한 번이면 확인된다. 워커 Writer가 자기 스레드 이름과 처리한 ID 구간을 남기게 해 두고, H2에 40건을 넣어 gridSize=4로 돌려 보면 된다. 아래는 Spring Boot 3.5 + Spring Batch 5.2로 실제 실행한 결과다.
먼저 어느 스레드가 어느 구간을 맡았는지 찍는 Writer다. 앞 워커 스텝의 writer 자리에 이걸 물린다.
@Bean
@StepScope
public ItemWriter<Order> workerWriter(
        @Value("#{stepExecutionContext['minValue']}") Long min,
        @Value("#{stepExecutionContext['maxValue']}") Long max) {
    return chunk -> {
        Thread.sleep(300);   // 처리 시간을 흉내내 병렬 실행이 타임스탬프에 겹쳐 보이게 한다
        log.info("[{}] 파티션 id {}~{} 처리 완료 → {}건 기록",
                Thread.currentThread().getName(), min, max, chunk.size());
    };
}Writer도 @StepScope로 두어 자기 파티션의 minValue·maxValue를 주입받는다. 실무라면 여기서 DB에 쓰겠지만, 병렬 실행을 눈으로 보려고 스레드 이름과 구간만 로그로 남겼다. Thread.sleep(300)은 처리 시간을 흉내 내 네 파티션의 로그 타임스탬프가 겹치도록 한 장치다. 스레드 풀은 앞의 함정 절에서 만든 part- 접두사 ThreadPoolTaskExecutor를 그대로 쓴다.
테스트 데이터는 H2에 id 1~40으로 40건을 넣었다.
CREATE TABLE orders (id BIGINT PRIMARY KEY, amount DECIMAL(10, 2));
INSERT INTO orders (id, amount) SELECT X, X * 100 FROM SYSTEM_RANGE(1, 40);Spring Boot는 기동 시 Job 빈을 자동 실행하므로 java -jar로 띄우기만 하면 매니저 스텝이 4개 파티션을 스레드 풀에 태운다. 실제 콘솔 출력은 다음과 같다.
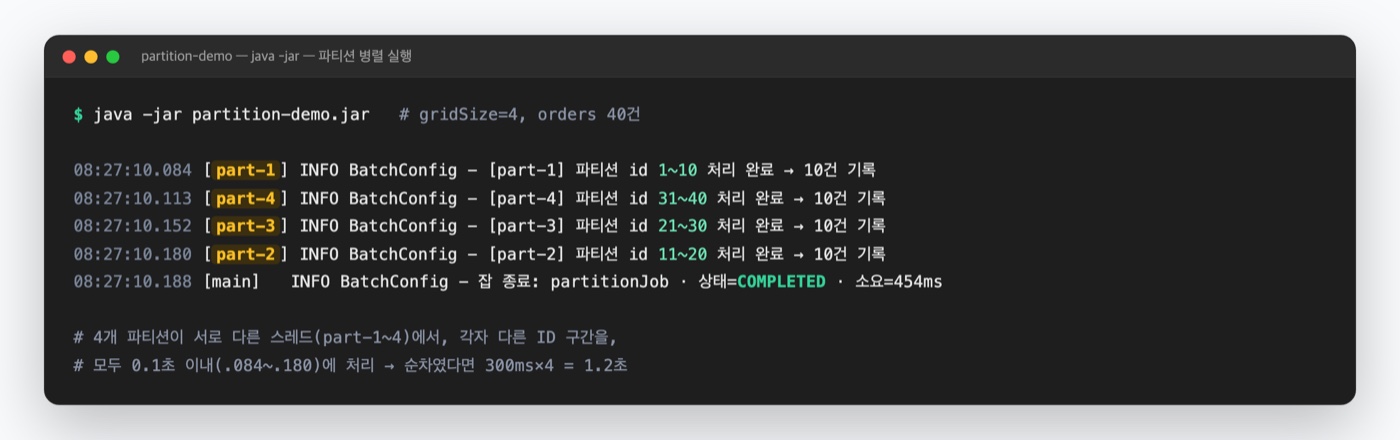
로그가 증명하는 건 세 가지다. 첫째, 네 줄이 각각 part-1·part-2·part-3·part-4라는 서로 다른 스레드에서 나왔다. 둘째, 각 스레드가 1~10, 11~20, 21~30, 31~40으로 겹치지 않는 ID 구간만 처리했다. 셋째, 네 줄의 타임스탬프가 .084부터 .180까지 0.1초 안에 몰려 있다. 각 파티션이 300ms씩 쉬었는데도 전체가 0.1초대에 끝났다는 건 순차 실행(300ms×4=1.2초)이 아니라 네 파티션이 진짜로 동시에 돌았다는 뜻이다. taskExecutor를 빼면 이 네 줄이 한 스레드에서 순서대로 찍히고 시간도 그만큼 늘어난다.
기동 즉시가 아니라 스케줄러로 원하는 시간에 돌리기
앞의 예제는 java -jar로 띄우면 잡이 바로 실행됐지만, 실무 배치는 대개 새벽 정산처럼 정해진 시각에 스케줄러로 돌린다. 방법은 세 단계다. 기동 시 자동 실행을 끄고, @Scheduled로 cron 시각에 JobLauncher가 잡을 실행하게 하고, 매 실행마다 유니크한 JobParameters를 넘긴다.
먼저 기동 자동 실행은 프로퍼티 한 줄로 끈다.
spring:
  batch:
    job:
enabled: false # 기동 시 잡을 자동 실행하지 않는다 (스케줄러가 대신 돌린다)이 줄이 없으면 Spring Boot가 기동하면서 한 번 돌리고, 새벽 2시에 스케줄러가 또 돌려 하루에 두 번 실행되는 사고가 난다. 스케줄러로 트리거할 거라면 기동 실행은 반드시 꺼야 한다.
그다음 @EnableScheduling을 켠 뒤(보통 메인 클래스에), cron 시각마다 JobLauncher로 잡을 실행하는 스케줄러를 둔다.
@Component
public class BatchScheduler {

    private final JobLauncher jobLauncher;
    private final Job partitionJob;

    public BatchScheduler(JobLauncher jobLauncher, Job partitionJob) {
        this.jobLauncher = jobLauncher;
        this.partitionJob = partitionJob;
    }

    @Scheduled(cron = "0 0 2 * * *")   // 매일 새벽 2시
    public void runPartitionJob() throws Exception {
        // 매 실행마다 유니크한 파라미터를 넣는다.
        // 같은 파라미터로는 Spring Batch가 같은 JobInstance로 보고 재실행을 막는다.
        JobParameters params = new JobParametersBuilder()
                .addLocalDateTime("runAt", LocalDateTime.now())
                .toJobParameters();
        jobLauncher.run(partitionJob, params);
    }
}여기서 제일 중요한 건 addLocalDateTime("runAt", ...)다. Spring Batch는 잡 이름과 JobParameters가 같으면 같은 JobInstance로 보고 이미 완료된 잡은 다시 실행하지 않는다(JobInstanceAlreadyCompleteException). 매일 도는 스케줄 배치라면 실행 시각 같은 유니크 값을 파라미터에 넣어야 매 주기 정상 실행된다. JobLauncher는 Spring Boot가 자동 구성하므로 생성자로 주입만 받으면 된다.
이 설정으로 테스트 삼아 cron을 3초마다로 바꿔 돌리면, 기동 때는 잡이 안 뜨다가 스케줄 시각마다 파티션 잡이 실행되는 것이 로그에 그대로 찍힌다.
17:45:52.307 [main]         Started PartitionDemoApplication   ← 기동만, 잡은 안 돎
17:45:54.011 [scheduling-1] 스케줄 트리거 → partitionJob 실행
17:45:54.405 [part-1~4]     id 1~10 / 11~20 / 21~30 / 31~40 동시 처리
17:45:54.419 [scheduling-1] 잡 종료: partitionJob · 상태=COMPLETED · 소요=365ms
17:45:57.005 [scheduling-1] 스케줄 트리거 → partitionJob 실행   ← 다음 주기, 또 실행
17:45:57.354 [scheduling-1] 잡 종료: partitionJob · 상태=COMPLETED · 소요=341ms기동 직후 Started 로그만 있고 잡은 돌지 않다가, 스케줄 시각마다 scheduling-1 스레드가 잡을 트리거하고 그 안에서 파티션이 병렬로 처리되는 흐름이 보인다. 유니크 파라미터 덕에 3초 주기가 매번 새 JobInstance로 실행된 것도 확인된다.
한 가지 주의가 있다. @Scheduled는 애플리케이션 인스턴스마다 독립적으로 돈다. 같은 배치 앱을 여러 대 띄우면 새벽 2시에 모든 인스턴스가 동시에 같은 잡을 실행해 중복이 난다. 이걸 막으려면 분산 락이 필요한데, 이 블로그의 ShedLock으로 스케줄러 중복 실행 막기와 cron 식을 런타임에 바꾸는 Spring Boot 동적 Cron 스케줄링에서 다뤘다. 스케줄 배치를 다중 인스턴스로 운영한다면 함께 챙겨야 한다.
다중 인스턴스에서 중복 실행 막기 — ShedLock
@Scheduled는 인스턴스마다 독립적으로 돈다. 그래서 배치 앱을 2대로 띄우면 새벽 2시에 두 인스턴스가 동시에 같은 잡을 실행해 정산이 두 번 도는 사고가 난다. 실제로 보호 없이 A·B 두 인스턴스를 같은 cron으로 띄우면 매 주기 둘 다 트리거되고 잡도 두 번 완료된다. 이걸 막는 표준 해법이 분산 락 라이브러리 ShedLock이다.
먼저 의존성을 추가한다.
<dependency>
    <groupId>net.javacrumbs.shedlock</groupId>
    <artifactId>shedlock-spring</artifactId>
    <version>5.16.0</version>
</dependency>
<dependency>
    <groupId>net.javacrumbs.shedlock</groupId>
    <artifactId>shedlock-provider-jdbc-template</artifactId>
    <version>5.16.0</version>
</dependency>락 상태는 모든 인스턴스가 공유하는 DB 테이블에 둔다. 여기서 “공유 DB”가 핵심이다. 인스턴스마다 각자의 DB를 쓰면 서로의 락을 못 봐서 소용이 없다.
CREATE TABLE shedlock (
    name       VARCHAR(64)  NOT NULL,
    lock_until TIMESTAMP(3) NOT NULL,
    locked_at  TIMESTAMP(3) NOT NULL,
    locked_by  VARCHAR(255) NOT NULL,
    PRIMARY KEY (name)
);@EnableSchedulerLock으로 락을 켜고, 공유 DataSource로 LockProvider를 등록한다.
@Configuration
@EnableSchedulerLock(defaultLockAtMostFor = "PT30S")
public class ShedLockConfig {
    @Bean
    public LockProvider lockProvider(DataSource dataSource) {
        return new JdbcTemplateLockProvider(
                JdbcTemplateLockProvider.Configuration.builder()
                        .withJdbcTemplate(new JdbcTemplate(dataSource))
                        .usingDbTime()   // DB 시간 기준 (인스턴스 간 시계 차 무시)
                        .build());
    }
}그리고 앞서 만든 스케줄 메서드에 @SchedulerLock만 붙이면 된다.
@Scheduled(cron = "0 0 2 * * *")
@SchedulerLock(name = "partition-batch-lock", lockAtMostFor = "PT20S", lockAtLeastFor = "PT1S")
public void runPartitionJob() throws Exception { /* ... */ }lockAtMostFor는 잡을 실행하던 인스턴스가 죽어도 이 시간이 지나면 락이 풀리게 하는 안전장치다. lockAtLeastFor는 최소 보유 시간으로, 잡이 너무 빨리 끝나 락이 즉시 풀렸을 때 인스턴스 간 시계 차로 다른 인스턴스가 또 잡는 중복을 막는다. 같은 두 인스턴스를 이번엔 공유 DB로 띄워 보면 결과가 달라진다.
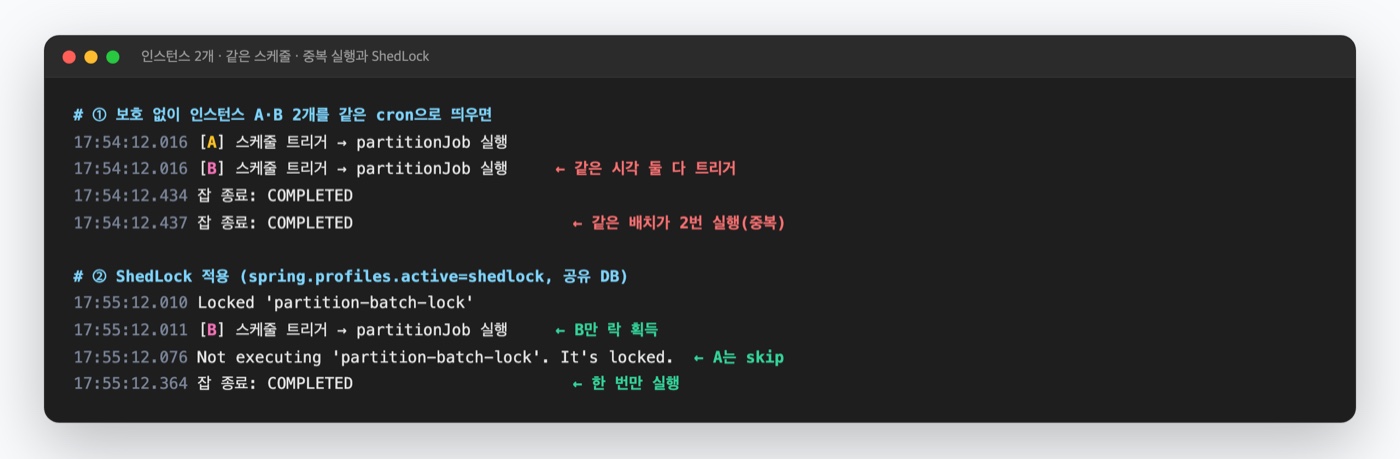
로그가 대비를 그대로 보여 준다. 보호가 없으면(①) A·B가 같은 시각에 트리거되고 잡이 두 번 COMPLETED된다. ShedLock을 켜면(②) 한 인스턴스만 Locked로 락을 잡아 실행하고, 다른 인스턴스는 Not executing 'partition-batch-lock'. It's locked.로 건너뛰어 잡이 한 번만 돈다. 락 저장소를 Redis로 바꾸는 등 ShedLock의 다른 설정은 이 블로그의 ShedLock으로 스케줄러 중복 실행 막기에서 더 다뤘다. 스케줄 배치를 두 대 이상으로 운영한다면 이 락은 선택이 아니라 필수다.
FAQ
멀티스레드 스텝과 파티셔닝 중 무엇을 써야 하나요?
간단한 병렬화면 멀티스레드 스텝, 대용량·재시작이 중요하면 파티셔닝이다. 멀티스레드 스텝은 설정이 간단하지만 하나의 Reader를 공유해 스레드 세이프 문제가 있고 재시작 시 어디까지 처리했는지 추적이 어렵다. 파티셔닝은 각 파티션이 독립된 실행 컨텍스트와 Reader를 가져 “실패한 파티션만 재실행”이 자연스럽다. 대용량 정산·마이그레이션처럼 재시작 안정성이 중요한 잡은 파티셔닝이 안전하다.
gridSize는 몇으로 잡는 게 좋나요?
코어 수, DB 커넥션 풀 크기, 대상 DB의 동시 쿼리 처리 능력 중 가장 낮은 값에 맞추는 것이 출발점이다. 무작정 늘리면 컨텍스트 스위칭과 커넥션 경합으로 오히려 느려진다. 실측 사례에서도 2코어 환경은 gridSize 2에서 정점을 찍고 4에서 꺾였다. 운영 데이터로 1, 2, 4를 실제로 재 보고 정하는 것이 정확하다.
파티션이 STARTING 상태로 멈췄습니다. 왜 그런가요?
TaskExecutor 스레드 풀이 파티션 수보다 작은데 큐 용량이 0이고 거부 정책이 AbortPolicy면, 자리가 없는 파티션이 제출과 동시에 거부되어 그 스텝이 STARTING에서 멈춘다. 큐 용량을 파티션 수 이상으로 늘리거나 거부 정책을 CallerRunsPolicy로 바꾸면 해결된다. 이미 멈춘 잡은 Spring Batch 6.0의 JobOperator.recover()로 고아 스텝을 닫은 뒤 재시작할 수 있다.
워커 스텝이 파티션 범위를 못 읽고 전체를 읽습니다.
@StepScope가 빠졌을 가능성이 높다. @Value("#{stepExecutionContext['minValue']}") 지연 바인딩은 스텝 스코프 빈에서만 동작한다. Reader 빈에 @StepScope가 없으면 컨텍스트 기동 시점에 minValue가 없어 바인딩이 실패하고, 결과적으로 조건 없이 전체를 읽게 된다. Reader에 @StepScope가 붙어 있는지부터 확인한다.
마치며
파티셔닝을 처음 도입했을 때 나도 gridSize를 16으로 크게 잡으면 16배 빨라질 줄 알았다. 결과는 정반대였다. 커넥션 풀이 8이라 절반의 워커는 커넥션을 기다리며 놀았고, DB는 동시 쿼리에 눌려 오히려 느려졌다. gridSize를 코어 수와 커넥션 풀에 맞춰 4로 내리고 나서야 제 성능이 나왔다. 그때 배운 건 파티셔닝의 병목은 거의 항상 애플리케이션이 아니라 DB라는 것이다. 대용량 배치를 손볼 때는 스레드부터 늘리기 전에 “이 잡의 진짜 병목이 CPU인가 DB인가”를 먼저 재 보길 권한다. 파티션을 아무리 쪼개도 DB가 못 받아 주면 소용이 없다. 지금까지 Spring Batch 파티셔닝으로 대용량 배치를 병렬화하는 방법과, gridSize·스레드 풀에서 실제로 걸리는 지점들을 정리해 보았다.